
Do código .NET 10 ao Kubernetes em 8 passos
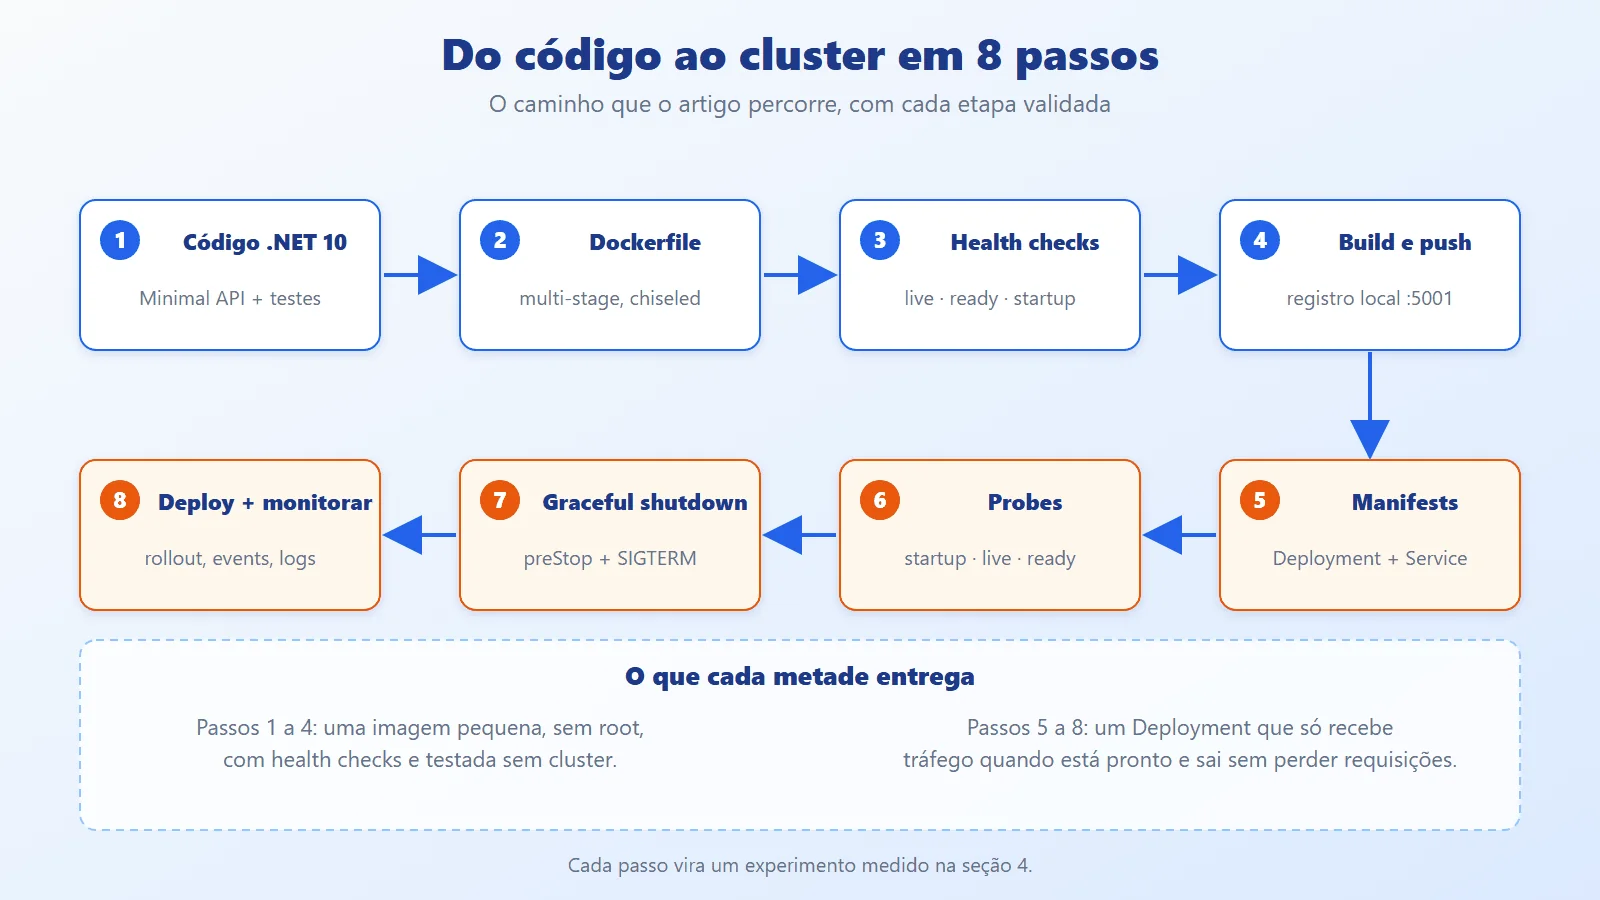
Uma API que funciona na máquina do desenvolvedor ainda não está pronta para o Kubernetes. Em produção, o orquestrador mata e recria pods o tempo todo (deploy, escala, manutenção de nó), e a aplicação precisa responder a três perguntas que o dotnet run nunca fez: já terminei de subir? Ainda estou vivo? Posso receber tráfego agora? Sem respostas corretas, um deploy derruba requisições, uma dependência lenta reinicia todos os pods de uma vez e uma imagem de 1,3 GB roda como root.
Este artigo, que continua a série depois de Tolerância a Falhas vs Resiliência e Rate Limiting, percorre o caminho completo com uma API de pedidos real em .NET 10: Dockerfile multi-stage com imagem chiseled e usuário não-root, health checks, graceful shutdown, manifests com Kustomize e um cluster kind local. Tudo foi executado e medido (tempos, tamanhos, restartCount, erros sob carga); o que não deu para rodar está dito na seção 4.12.
Conceitos de Kubernetes: pods, probes e ciclo de vida
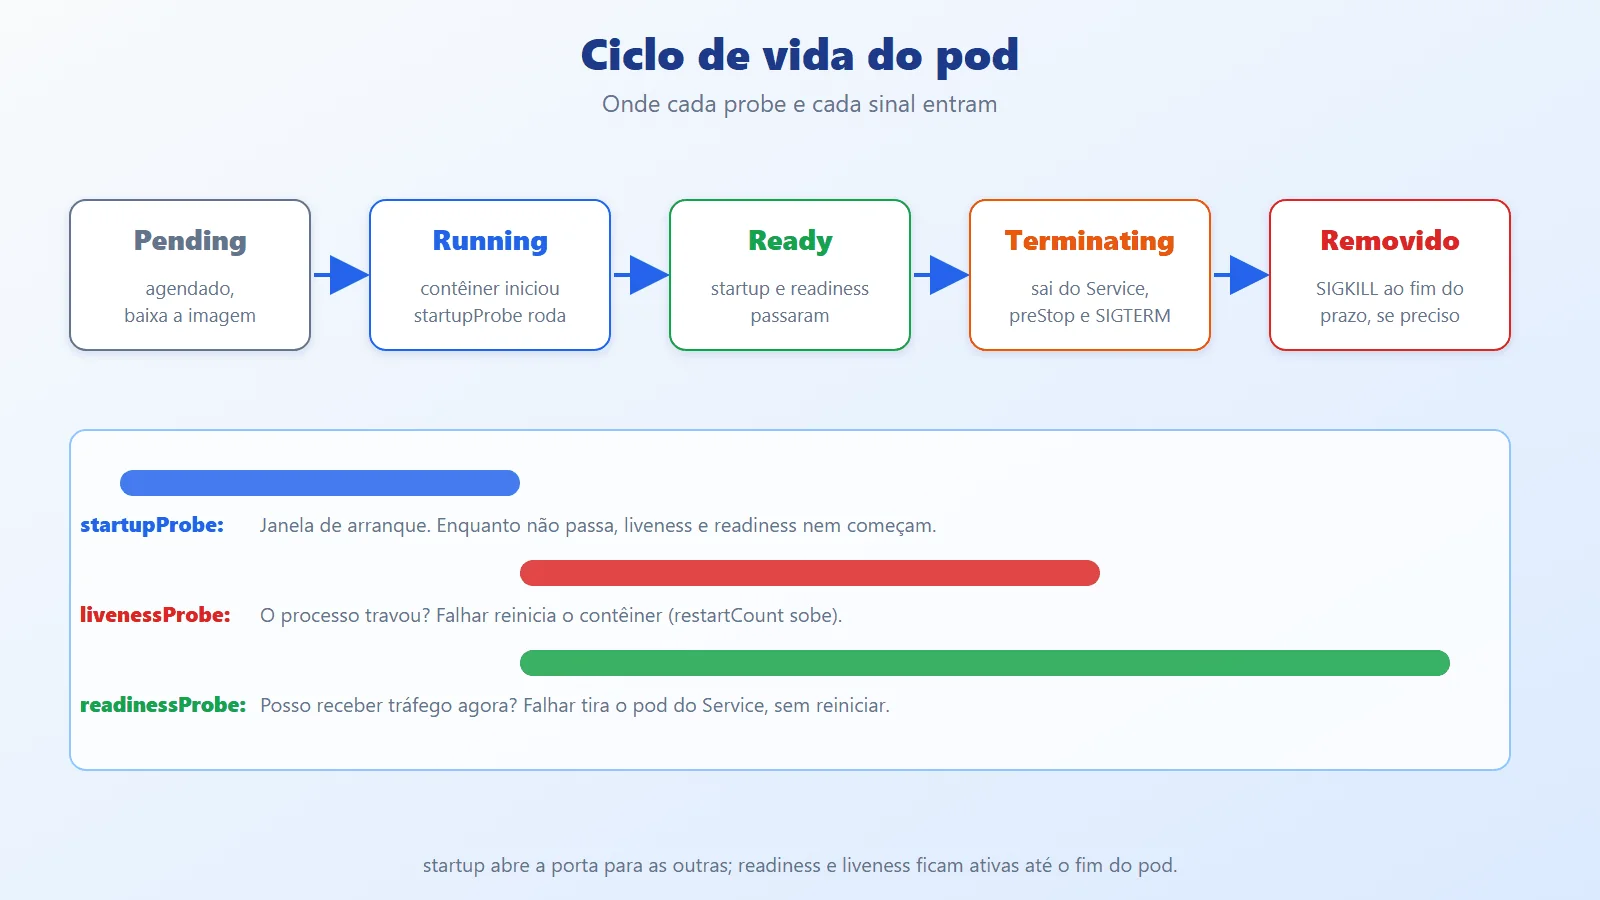
Pod, imagem e contêiner. A imagem é o artefato imutável; o contêiner é um processo isolado criado a partir dela; o pod é a menor unidade que o Kubernetes agenda (um ou mais contêineres que compartilham rede). Quem recria pods é o ReplicaSet, controlado pelo Deployment.
As três probes. Cada uma faz uma pergunta diferente e tem uma consequência diferente:
- startupProbe: "já terminei de subir?". Enquanto não passa, as outras duas nem começam. Falhar até o limite reinicia o contêiner.
- livenessProbe: "o processo está vivo?". Falhar reinicia o contêiner.
- readinessProbe: "posso receber tráfego agora?". Falhar não reinicia: apenas tira o pod do Service.

Cada probe pode ser httpGet, tcpSocket, grpc ou exec. Em uma imagem chiseled não existe shell, então exec (curl, sh) não funciona e httpGet é a escolha natural:
livenessProbe:


  httpGet:


    path: /health/live


    port: http


  periodSeconds: 5      # de quanto em quanto tempo


  timeoutSeconds: 2     # quanto esperar a resposta


  failureThreshold: 3   # falhas seguidas para agir
Os campos periodSeconds, timeoutSeconds e failureThreshold definem o tempo de reação: aqui, três falhas de 2 s a cada 5 s. Na API, cada pergunta vira uma rota e cada rota executa só os checks com a sua tag:
app.MapHealthChecks("/health/live", Saude.Rota("live"));


app.MapHealthChecks("/health/ready", Saude.Rota("ready"));
Saude.Rota devolve um HealthCheckOptions com Predicate = r => r.Tags.Contains(tag). Assim, /health/live nunca executa o check que fala com a dependência.
Término do pod. Quando o pod é removido, o Kubernetes marca-o como Terminating, tira-o dos endpoints, executa o gancho preStop, envia SIGTERM e, passado o terminationGracePeriodSeconds, envia SIGKILL. Para o SIGTERM chegar ao .NET, o processo precisa ser o PID 1 do contêiner, e isso depende de como o ENTRYPOINT é escrito:
# Forma shell: o /bin/sh vira PID 1 e NÃO repassa o SIGTERM


ENTRYPOINT dotnet out/Pedidos.dll


# Forma exec: o dotnet é o PID 1 e recebe o SIGTERM


ENTRYPOINT ["dotnet", "Pedidos.dll"]
A forma shell parece inofensiva, mas a seção 4.5 mostra o custo medido: docker stop esperou o prazo inteiro e terminou com SIGKILL (exit code 137).
Imagem chiseled. São imagens Ubuntu "cinzeladas" da Microsoft: só o necessário para rodar o .NET, sem shell, sem gerenciador de pacotes e com um usuário não-root (UID 1654, variável APP_UID). Menor, com menos superfície de ataque.
Limites de recurso. O .NET lê os limites do cgroup do contêiner: Environment.ProcessorCount reflete o limite de CPU (arredondado para cima) e o GC usa uma fração do limite de memória como teto. Os números medidos estão na seção 4.11.
Resumo medido das imagens, que justifica o formato escolhido (o detalhe vem na seção 3.1):
$ docker images pedidos --format "{{.Tag}} {{.Size}}"


ingenua 1.3GB


noble 340MB


1.0 180MB
Arquitetura: imagem, health checks e rolling update
A imagem: multi-stage, cache e chiseled
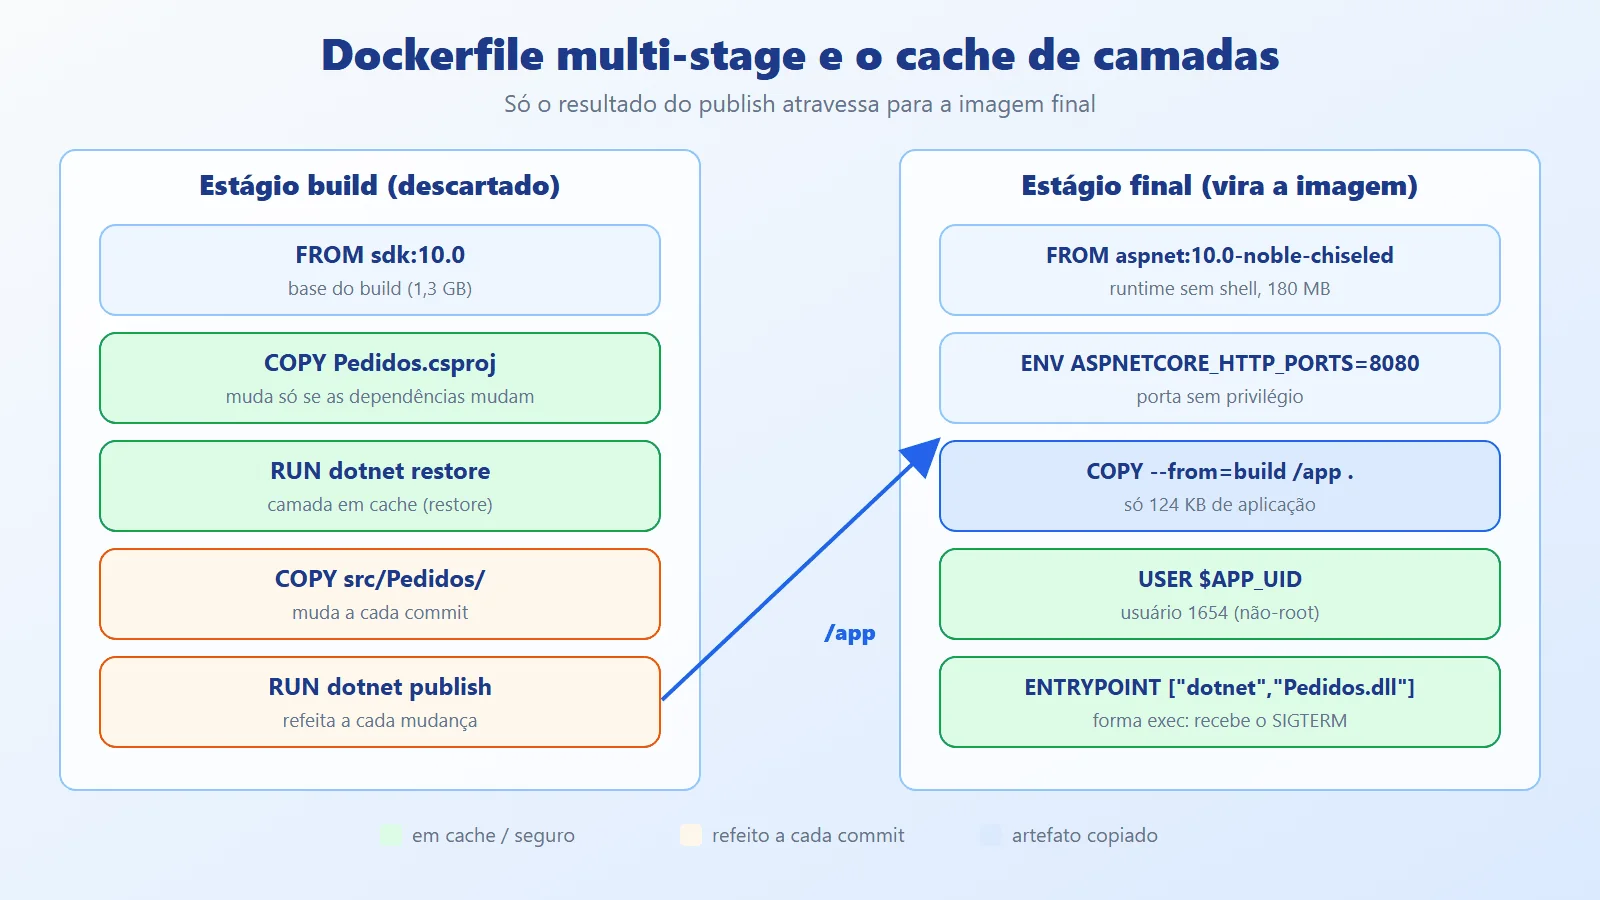
O build usa dois estágios. O primeiro (sdk:10.0) restaura e publica; o segundo (aspnet:10.0-noble-chiseled) recebe apenas o resultado do publish. O SDK, o código-fonte e o cache do NuGet ficam para trás. A ordem das instruções importa: copiar só o .csproj antes do restore mantém essa camada em cache enquanto as dependências não mudam.
COPY src/Pedidos/Pedidos.csproj src/Pedidos/


RUN dotnet restore src/Pedidos/Pedidos.csproj


COPY src/Pedidos/ src/Pedidos/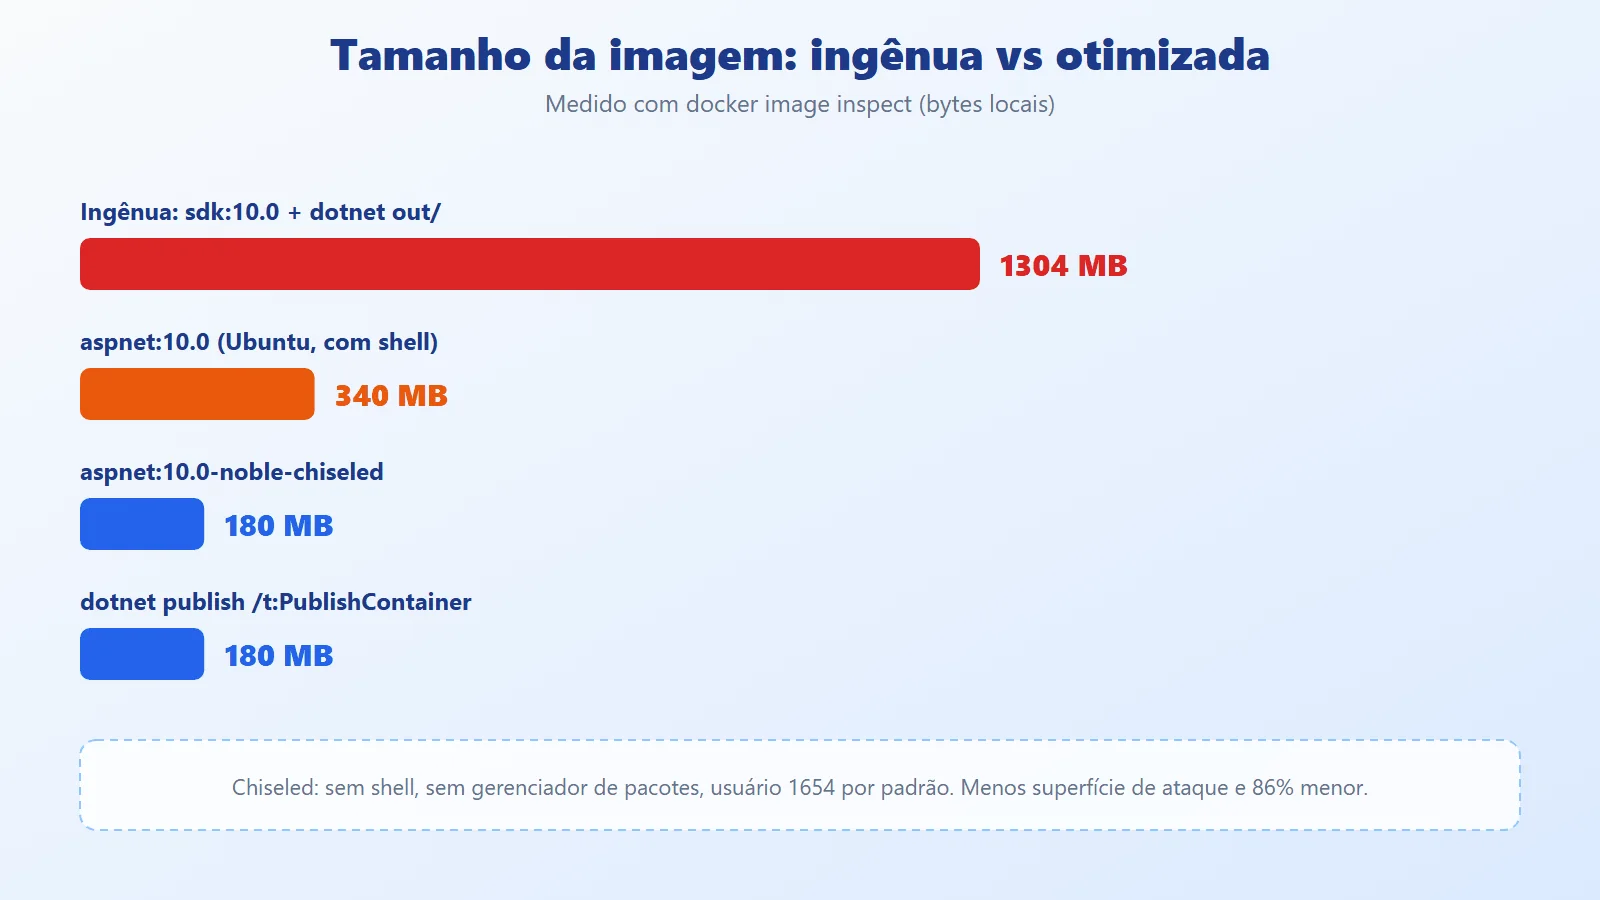
O estágio final termina com USER $APP_UID (numérico, para o runAsNonRoot do Kubernetes conseguir verificar) e ENTRYPOINT em forma exec. O .dockerignore mantém bin/, obj/, .git/ e k8s/ fora do contexto de build.
Health checks: uma pergunta por endpoint
O ASP.NET Core separa registrar o check (com tags) de expor a rota (com Predicate). Cada check é uma classe pequena que responde só à sua pergunta. O /health/ready é o único que consulta a dependência, e com timeout: uma dependência lenta não pode pendurar a probe.
using var cts =


    CancellationTokenSource.CreateLinkedTokenSource(ct);


cts.CancelAfter(TimeSpan.FromSeconds(2));
O CancelAfter garante que, mesmo que o ping nunca volte, o check responde Unhealthy em 2 s (mensagem "dependencia lenta") em vez de deixar a probe estourar o próprio timeoutSeconds.
Graceful shutdown: sinalizar, esperar, terminar

Fechar um pod sem perder requisições tem três tempos: (1) o pod sai dos endpoints (isso leva alguns instantes para propagar pelo cluster); (2) o processo é avisado com SIGTERM; (3) as requisições em voo terminam. A aplicação participa de dois deles. Ao receber o sinal, ela passa a responder 503 na readiness e espera alguns segundos antes de o Kestrel parar de aceitar conexões. O gancho certo para isso é o IHostedLifecycleService.StoppingAsync, que roda antes do StopAsync de todos os serviços (inclusive o servidor web):
public async Task StoppingAsync(CancellationToken ct)


{


    var s = config.GetValue("Shutdown:DrenagemSegundos", 3);


    estado.Drenando = true;


    log.LogInformation("2. Drenando (readiness 503) {S}s", s);


    await Task.Delay(TimeSpan.FromSeconds(s), ct);


}
A primeira versão deste código fazia a espera em StopAsync de um IHostedService. Não funcionou: os serviços param em ordem inversa ao registro e o Kestrel (registrado depois) parava antes do serviço de drenagem, que então esperava em vão. O StoppingAsync resolve a ordem.
Manifests e o rolling update
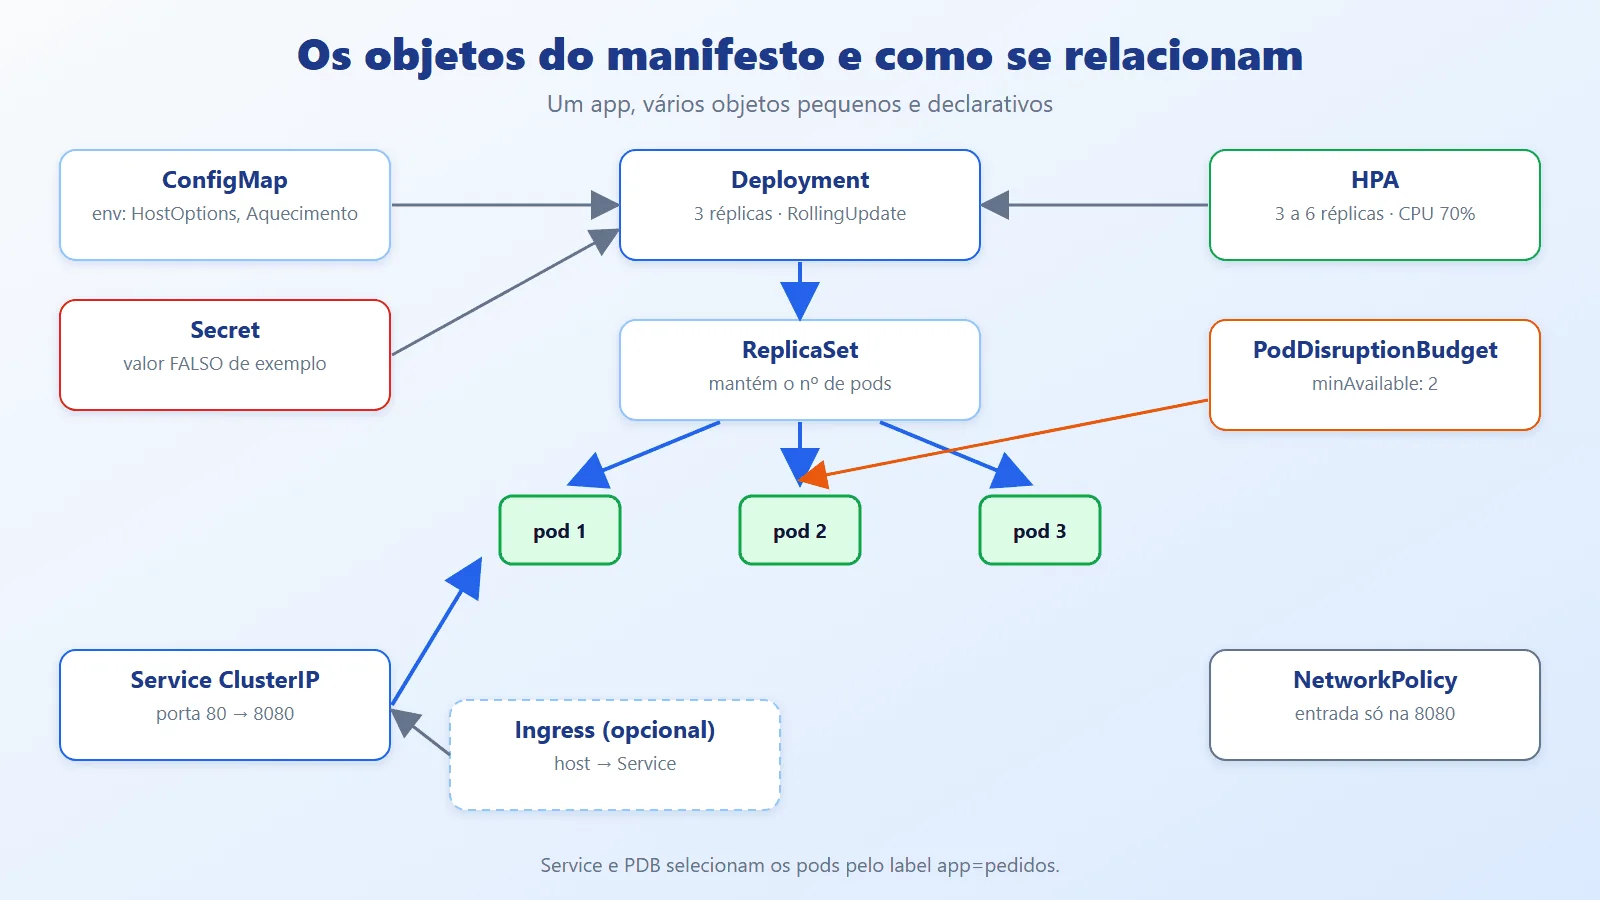
O Deployment descreve o pod desejado e a estratégia de troca; o Service (ClusterIP) dá um endereço estável e só encaminha para pods Ready; ConfigMap e Secret injetam configuração por variável de ambiente; o HPA ajusta as réplicas; o PodDisruptionBudget limita quantos pods podem sair ao mesmo tempo em manutenções voluntárias; a NetworkPolicy restringe a entrada. A estratégia de troca é a peça que protege o deploy:
strategy:


  type: RollingUpdate


  rollingUpdate:


    maxSurge: 1


    maxUnavailable: 0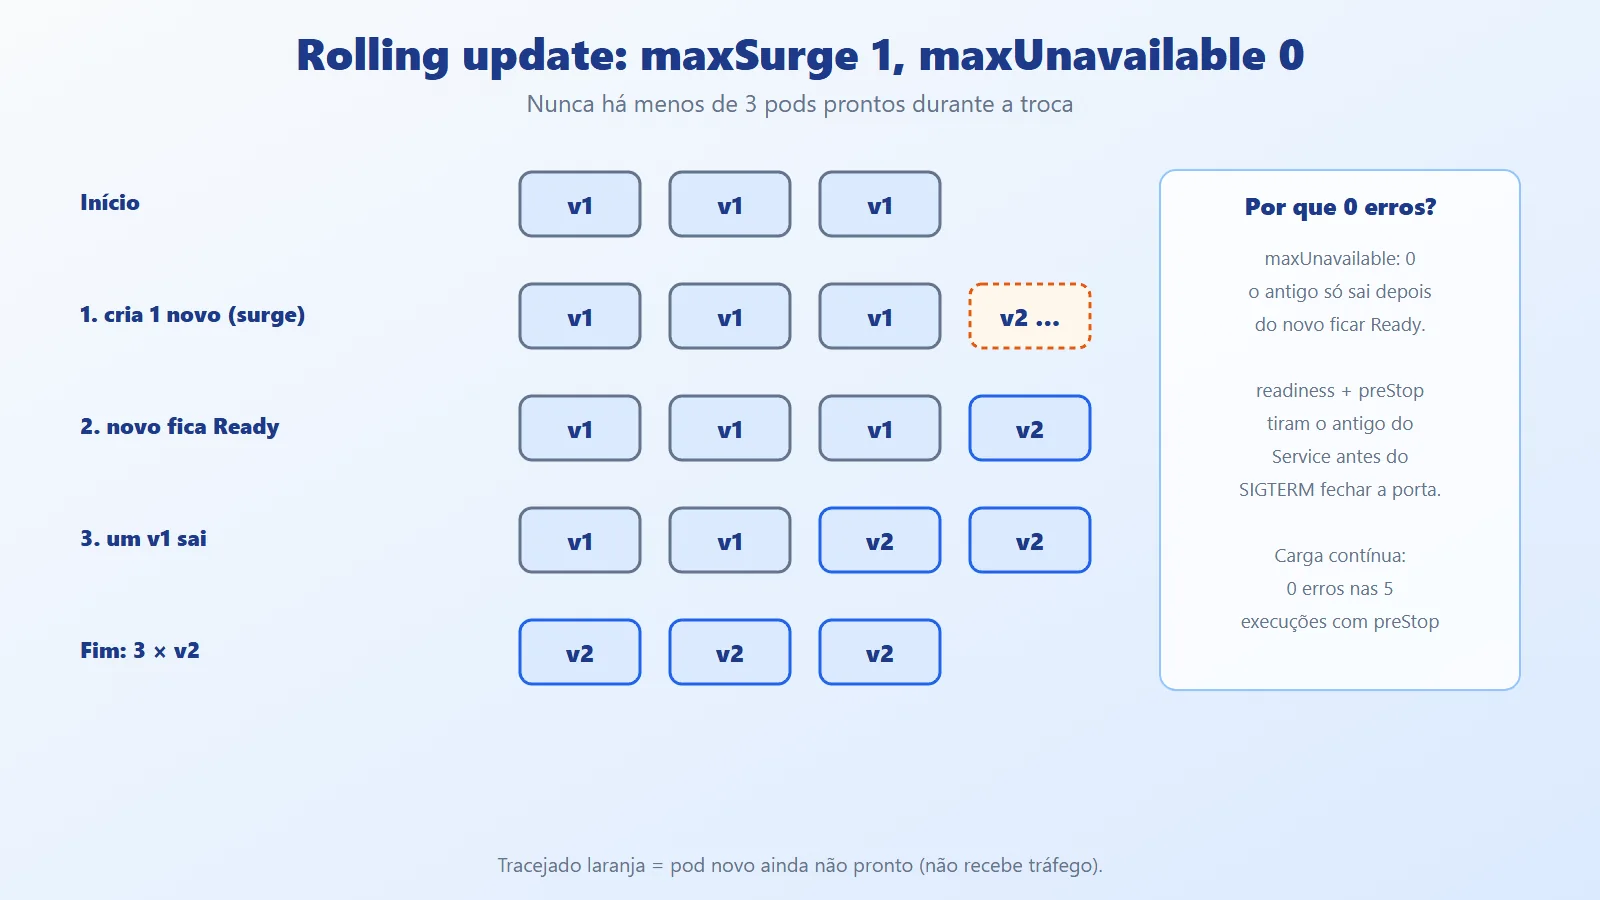
maxSurge: 1 permite criar um pod extra durante a troca; maxUnavailable: 0 proíbe derrubar um pod antigo antes de o novo ficar Ready. A capacidade nunca cai abaixo das 3 réplicas.
Kustomize: uma base, vários ambientes
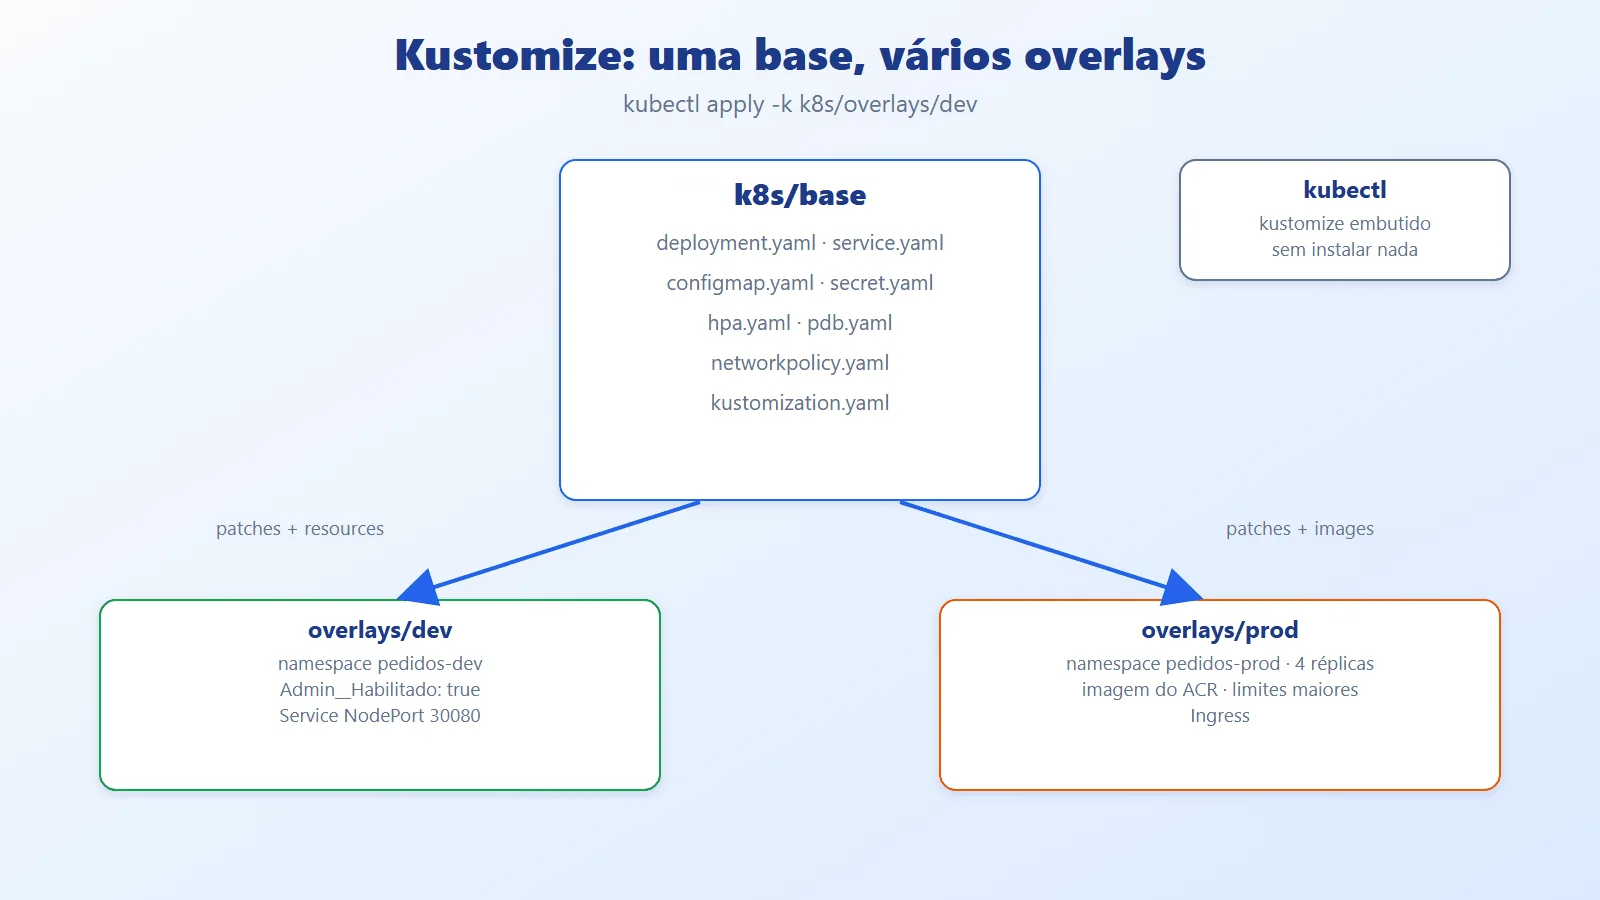
A pasta k8s/base descreve o app uma vez; cada overlay (dev, prod) aplica patches sobre ela: namespace, número de réplicas, imagem, limites. O kubectl já traz o Kustomize embutido, então não há o que instalar:
kubectl kustomize k8s/overlays/prod   # só renderiza


kubectl apply -k k8s/overlays/dev     # renderiza e aplica
Exemplo prático: API .NET no Kubernetes com kind
O repositório kubernetes-dotnet tem tudo o que aparece aqui, e os blocos deste artigo são os próprios arquivos. A API é uma Minimal API de pedidos pequena; o foco são os pontos de integração com o Kubernetes.
Pré-requisitos e instalação, passo a passo

O Windows é o ambiente principal. A ordem importa: o .NET 10 SDK é independente; o WSL 2 vem primeiro, depois o Docker Desktop (que usa o WSL 2 como motor), e só então kubectl e kind, que precisam do Docker rodando. Os IDs do winget abaixo foram conferidos com winget search; os binários do kind e do kubectl que usei na validação foram baixados dos sites oficiais, sem instalação global.
Passo 1: .NET 10 SDK (download oficial).
winget install Microsoft.DotNet.SDK.10


dotnet --version10.0.401Passo 2: WSL 2 (documentação). Em um PowerShell como administrador; exige reiniciar o Windows e a virtualização habilitada na BIOS/UEFI.
wsl --install


wsl --status
Passo 3: Docker Desktop (instalação no Windows). Abra o aplicativo uma vez, aceite os termos e espere o status Engine running.
winget install Docker.DockerDesktop


docker version --format "{{.Server.Version}}"29.8.1Passo 4: kubectl (ferramentas oficiais). O Kustomize já vem dentro do kubectl.
winget install Kubernetes.kubectl


kubectl version --clientClient Version: v1.36.1
Kustomize Version: v5.8.1Passo 5: kind (guia oficial). Pelo winget, ou baixando o binário e conferindo o checksum publicado (foi o que fiz, em uma pasta local, sem alterar o PATH do sistema):
winget install Kubernetes.kind


kind versionkind v0.33.0 go1.26.7 windows/amd64$u = "https://github.com/kubernetes-sigs/kind/releases"
$u = "$u/download/v0.33.0/kind-windows-amd64"
curl.exe -sLo kind.exe $u
curl.exe -sL "$u.sha256sum"
(Get-FileHash kind.exe).Hash.ToLower()Os dois últimos comandos precisam imprimir o mesmo hash (4b22adaa...15c9fc na minha validação). A instalação do Docker Desktop do zero não foi refeita nesta máquina (já estava instalada); esse passo vem da documentação oficial.
Linux e macOS. As mesmas ferramentas existem: use o gerenciador de pacotes da distribuição (ou o Homebrew) ou as páginas de download linkadas acima. Não há WSL; no Linux o Docker Engine roda direto.
Criar e remover o cluster. O contexto do kubectl muda para o cluster novo; confira sempre antes de aplicar qualquer coisa:
kind create cluster --name artigo-k8s `


  --config k8s/kind-config.yaml


kubectl config get-contexts


kind get clustersCURRENT NAME CLUSTER AUTHINFO
* kind-artigo-k8s kind-artigo-k8s kind-artigo-k8s
artigo-k8sNo fim, a remoção desfaz o cluster e o contexto:
kind delete cluster --name artigo-k8s


kind get clusters
Problemas comuns de instalação:
Sintoma: "WSL 2 requires an update" / Docker não inicia


Causa:   virtualização desabilitada ou WSL desatualizado


Correção: habilitar virtualização na BIOS; wsl --update


Sintoma: error during connect: ... dockerDesktopLinuxEngine


Causa:   Docker Desktop fechado


Correção: abrir o app e esperar "Engine running"


Sintoma: port is already allocated (30080 ou 5001)


Correção: netstat -ano | findstr :30080 ; trocar hostPort


Sintoma: kubectl fala com o cluster errado


Correção: kubectl config use-context kind-artigo-k8s
Tudo pronto? Um mini checklist, e o comando para obter o código e rodar o primeiro build:
dotnet --version && docker version --format "{{.Server.Version}}"


kubectl version --client && kind version


git clone https://github.com/ceseidl/kubernetes-dotnet


cd kubernetes-dotnet


dotnet test Pedidos.slnx
Se dotnet test passar (8 testes), o ambiente está pronto. O repositório ainda não é público na data deste texto; até a publicação, o código está só na máquina do autor.
O projeto e o ponto de entrada
A API usa o SDK Microsoft.NET.Sdk.Web. InvariantGlobalization evita depender da ICU, que não existe na imagem chiseled:
<Project Sdk="Microsoft.NET.Sdk.Web">


  <PropertyGroup>


    <TargetFramework>net10.0</TargetFramework>


    <Nullable>enable</Nullable>


    <ImplicitUsings>enable</ImplicitUsings>


    <InvariantGlobalization>true</InvariantGlobalization>


  </PropertyGroup>


</Project>
O Program.cs registra o estado compartilhado, a dependência (trocável por um fake nos testes), os dois serviços de ciclo de vida e os três health checks com as suas tags, além dos logs em JSON no stdout (o formato que os coletores de log do cluster esperam). O middleware devolve o nome do pod no cabeçalho X-Pod, usado depois para provar a distribuição de carga:
using Pedidos;


var builder = WebApplication.CreateBuilder(args);


builder.Logging.AddJsonConsole(o =>


    o.TimestampFormat = "HH:mm:ss.fff ");


builder.Services.AddSingleton<EstadoApp>();


builder.Services


    .AddSingleton<IDependencia, DependenciaSimulada>();


builder.Services.AddHostedService<Aquecimento>();


builder.Services.AddHostedService<Drenagem>();


builder.Services.AddHealthChecks()


    .AddCheck<VivoCheck>("vivo", tags: ["live"])


    .AddCheck<ProntoCheck>("dependencia", tags: ["ready"])


    .AddCheck<CacheCheck>("cache", tags: ["startup"]);


var app = builder.Build();


app.Use(async (http, next) =>


{


    http.Response.Headers["X-Pod"] = Environment.MachineName;


    await next();


});


app.MapHealthChecks("/health/live", Saude.Rota("live"));


app.MapHealthChecks("/health/ready", Saude.Rota("ready"));


app.MapHealthChecks("/health/startup", Saude.Rota("startup"));


app.MapPedidos();


app.MapInfo();


app.MapAdmin();


app.Run();


public partial class Program;
Health checks
O estado compartilhado e a dependência simulada. A dependência é uma interface porque, em produção, seria um banco ou uma fila; no teste, vira um fake:
namespace Pedidos;


/// Estado compartilhado que os health checks consultam.


public sealed class EstadoApp


{


    public volatile bool CacheAquecido;


    public volatile bool Drenando;


    public volatile bool Travado;


    public volatile bool DependenciaLigada = true;


    public int LatenciaDependenciaMs;


}namespace Pedidos;
/// Dependencia externa (banco, fila...). Simulada no exemplo.
public interface IDependencia
{
Task<bool> PingAsync(CancellationToken ct);
}
public sealed class DependenciaSimulada(EstadoApp estado)
: IDependencia
{
public async Task<bool> PingAsync(CancellationToken ct)
{
await Task.Delay(estado.LatenciaDependenciaMs, ct);
return estado.DependenciaLigada;
}
}Os três checks: o liveness só olha o processo (e finge um deadlock quando Travado está ligado), o readiness respeita a drenagem e o timeout da dependência, e o startup espera o cache aquecer:
using Microsoft.Extensions.Diagnostics.HealthChecks;


namespace Pedidos;


using Ctx = HealthCheckContext;


using Res = HealthCheckResult;


/// Liveness: so olha para o proprio processo. Nada de banco.


public sealed class VivoCheck(EstadoApp estado) : IHealthCheck


{


    public async Task<Res> CheckHealthAsync(


        Ctx ctx, CancellationToken ct = default)


    {


        // Simula um deadlock: o processo vive, mas nao responde.


        if (estado.Travado)


            await Task.Delay(Timeout.Infinite, ct);


        return Res.Healthy("processo responde");


    }


}


/// Readiness: pronto para receber trafego agora?


public sealed class ProntoCheck(


    EstadoApp estado, IDependencia dependencia) : IHealthCheck


{


    public async Task<Res> CheckHealthAsync(


        Ctx ctx, CancellationToken ct = default)


    {


        if (estado.Drenando)


            return Res.Unhealthy("drenando (SIGTERM recebido)");


        using var cts =


            CancellationTokenSource.CreateLinkedTokenSource(ct);


        cts.CancelAfter(TimeSpan.FromSeconds(2));


        try


        {


            return await dependencia.PingAsync(cts.Token)


                ? Res.Healthy("dependencia ok")


                : Res.Unhealthy("dependencia fora do ar");


        }


        catch (OperationCanceledException)


            when (!ct.IsCancellationRequested)


        {


            return Res.Unhealthy("dependencia lenta (> 2 s)");


        }


    }


}


/// Startup: o cache de arranque ja foi aquecido?


public sealed class CacheCheck(EstadoApp estado) : IHealthCheck


{


    public Task<Res> CheckHealthAsync(


        Ctx ctx, CancellationToken ct = default) =>


        Task.FromResult(estado.CacheAquecido


            ? Res.Healthy("cache aquecido")


            : Res.Unhealthy("cache aquecendo"));


}
O Saude.Rota converte uma tag em HealthCheckOptions e escreve um JSON legível (os códigos HTTP vêm do padrão: Unhealthy vira 503):
using Microsoft.AspNetCore.Diagnostics.HealthChecks;


namespace Pedidos;


public static class Saude


{


    /// Cada rota executa so os checks com a sua tag.


    public static HealthCheckOptions Rota(string tag) => new()


    {


        Predicate = r => r.Tags.Contains(tag),


        ResponseWriter = (http, rel) =>


            http.Response.WriteAsJsonAsync(new


            {


                status = rel.Status.ToString(),


                checks = rel.Entries.Select(e => new


                {


                    nome = e.Key,


                    status = e.Value.Status.ToString(),


                    detalhe = e.Value.Description


                })


            })


    };


}
Arranque lento e graceful shutdown
O Aquecimento simula um arranque lento (cache, migrações, JIT). No modo bloqueante, o Kestrel só abre a porta depois de aquecer, como uma app que migra o banco antes de escutar:
namespace Pedidos;


/// Simula um arranque lento (cache, migracoes, JIT).


public sealed class Aquecimento(


    EstadoApp estado,


    IConfiguration config,


    ILogger<Aquecimento> log) : BackgroundService


{


    public override async Task StartAsync(CancellationToken ct)


    {


        // Bloqueante: o Kestrel so abre a porta apos aquecer,


        // como uma app que migra o banco antes de escutar.


        if (config.GetValue<bool>("Aquecimento:Bloqueante"))


            await AquecerAsync(ct);


        await base.StartAsync(ct);


    }


    protected override Task ExecuteAsync(CancellationToken ct) =>


        AquecerAsync(ct);


    async Task AquecerAsync(CancellationToken ct)


    {


        if (estado.CacheAquecido) return;


        var s = config.GetValue("Aquecimento:Segundos", 3);


        log.LogInformation("Aquecendo cache por {S}s", s);


        await Task.Delay(TimeSpan.FromSeconds(s), ct);


        estado.CacheAquecido = true;


        log.LogInformation("Cache aquecido");


    }


}
E a Drenagem registra a sequência numerada do desligamento (1 a 4), que aparece nos logs dos experimentos:
namespace Pedidos;


/// Ao receber SIGTERM, avisa o balanceador (readiness 503)


/// e espera ANTES de o Kestrel parar de aceitar conexoes.


public sealed class Drenagem(


    EstadoApp estado,


    IConfiguration config,


    IHostApplicationLifetime vida,


    ILogger<Drenagem> log) : IHostedLifecycleService


{


    public Task StartingAsync(CancellationToken ct)


    {


        vida.ApplicationStopping.Register(() =>


            log.LogInformation("1. Stopping (SIGTERM)"));


        vida.ApplicationStopped.Register(() =>


            log.LogInformation("4. Stopped"));


        return Task.CompletedTask;


    }


    // Roda antes do StopAsync de TODOS os servicos (inclusive


    // o Kestrel), por isso a drenagem fica aqui.


    public async Task StoppingAsync(CancellationToken ct)


    {


        var s = config.GetValue("Shutdown:DrenagemSegundos", 3);


        estado.Drenando = true;


        log.LogInformation("2. Drenando (readiness 503) {S}s", s);


        await Task.Delay(TimeSpan.FromSeconds(s), ct);


        log.LogInformation("3. Fim da drenagem, fechando");


    }


    static Task Nada => Task.CompletedTask;


    public Task StartAsync(CancellationToken ct) => Nada;


    public Task StartedAsync(CancellationToken ct) => Nada;


    public Task StopAsync(CancellationToken ct) => Nada;


    public Task StoppedAsync(CancellationToken ct) => Nada;


}
Os endpoints de negócio e de apoio ficam em Endpoints.cs. O /lento simula uma requisição demorada (para provar o shutdown), o /info expõe o que o .NET enxerga do contêiner e o grupo /admin só existe com Admin:Habilitado=true:
        // Requisicao longa: prova o shutdown graceful.


        app.MapGet("/lento", async (int segundos) =>


        {


            await Task.Delay(TimeSpan.FromSeconds(segundos));


            return new


            {


                concluido = true,


                pod = Environment.MachineName


            };


}); public static void MapAdmin(this WebApplication app)
{
if (!app.Configuration.GetValue<bool>("Admin:Habilitado"))
return;
var adm = app.MapGroup("/admin");
var e = app.Services.GetRequiredService<EstadoApp>();
adm.MapPost("/dependencia/{ligada:bool}", (bool ligada) =>
e.DependenciaLigada = ligada);
adm.MapPost("/latencia/{ms:int}", (int ms) =>
e.LatenciaDependenciaMs = ms);
adm.MapPost("/travar", () => e.Travado = true);
}O Dockerfile, a imagem e o docker stop
Dockerfile final (multi-stage, chiseled, não-root, porta 8080):
# syntax=docker/dockerfile:1


FROM mcr.microsoft.com/dotnet/sdk:10.0 AS build


WORKDIR /src


# Camada de restore: so muda quando o .csproj muda.


COPY src/Pedidos/Pedidos.csproj src/Pedidos/


RUN dotnet restore src/Pedidos/Pedidos.csproj


COPY src/Pedidos/ src/Pedidos/


RUN dotnet publish src/Pedidos/Pedidos.csproj \


    -c Release --no-restore -o /app /p:UseAppHost=false


FROM mcr.microsoft.com/dotnet/aspnet:10.0-noble-chiseled


WORKDIR /app


ENV ASPNETCORE_HTTP_PORTS=8080


EXPOSE 8080


COPY --from=build /app .


USER $APP_UID


ENTRYPOINT ["dotnet", "Pedidos.dll"]
Para comparar, a versão ingênua: um estágio só, SDK como base, COPY . ., root e ENTRYPOINT em forma shell:
# Versao INGENUA, so para comparar tamanho e shutdown.


FROM mcr.microsoft.com/dotnet/sdk:10.0


WORKDIR /app


COPY . .


RUN dotnet publish src/Pedidos/Pedidos.csproj -c Release -o out


ENV ASPNETCORE_URLS=http://+:8080


ENTRYPOINT dotnet out/Pedidos.dll
Medições (docker image inspect, bytes locais do Docker 29.8.1):
pedidos:ingenua                               1.304 MB


aspnet:10.0 (Ubuntu, com shell)                 340 MB


aspnet:10.0-noble-chiseled                      180 MB


pedidos:1.0 (chiseled + app, 124 KB de app)     180 MB


dotnet publish -t:PublishContainer              180 MB
A imagem ingênua é 7 vezes maior. O build otimizado levou 16,2 s do zero (--no-cache) e 10 a 12 s depois de alterar um arquivo, com a camada do restore em CACHED. Atenção a uma limitação honesta da medição: esta API não tem pacotes NuGet, então o restore é quase instantâneo e o ganho do cache de camadas não apareceu em segundos (a versão ingênua refez o build em 9,4 s). O cache vale quando há dependências de verdade.
A alternativa sem Dockerfile é o SDK de contêineres do .NET, que gerou uma imagem equivalente (180 MB, usuário 1654, ENTRYPOINT dotnet /app/Pedidos.dll):
dotnet publish src/Pedidos -c Release -t:PublishContainer \


  -p:ContainerRepository=pedidos-sdk -p:ContainerImageTag=1.0 \


  -p:ContainerFamily=noble-chiseled
Experimento (a): docker stop com uma requisição de 20 s em voo. O script sobe o contêiner, dispara /lento?segundos=20, espera 2 s e para o contêiner:
#!/usr/bin/env bash


# Experimento (a): docker stop com uma requisicao em voo.


# Uso: scripts/exp-a-docker-stop.sh <imagem> <timeout-do-stop>


IMG=${1:-pedidos:1.0}; T=${2:-30}


SED='s/.*mp":"([^"]*)".*ge":"([^"]*)".*/\1 \2/'


docker rm -f pedidos-a >/dev/null 2>&1


docker run -d --name pedidos-a -p 8081:8080 "$IMG" >/dev/null


until curl -sf localhost:8081/health/startup >/dev/null; do


  sleep 1


done


curl -s -m 60 -w ' http=%{http_code} em %{time_total}s\n' \


  'localhost:8081/lento?segundos=20' &


sleep 2


INI=$(date +%s%N)


docker stop -t "$T" pedidos-a >/dev/null


FIM=$(date +%s%N)


wait


echo "docker stop levou $(( (FIM - INI) / 1000000 )) ms"


CODE=$(docker inspect -f '{{.State.ExitCode}}' pedidos-a)


echo "exit code: $CODE"


docker logs pedidos-a 2>&1 \


  | grep -E 'Stopping|Drenando|Fim da|Stopped|lento .* 200' \


  | sed -E "$SED" | cut -c1-60


docker rm -f pedidos-a >/dev/null
Resultados, rodando o mesmo script três vezes:
ingenua, docker stop -t 10:


  requisição: http=000 (conexão cortada)


  docker stop levou 11621 ms, exit code 137


  logs: nenhuma linha de desligamento


pedidos:1.0, docker stop -t 30:


  {"concluido":true,...} http=200 em 20.01s


  docker stop levou 18491 ms, exit code 0


  04:13:10.697 1. Stopping (SIGTERM)


  04:13:10.699 2. Drenando (readiness 503) 3s


  04:13:13.702 3. Fim da drenagem, fechando


  04:13:27.487 4. Stopped


pedidos:1.0, docker stop -t 5:


  requisição: http=000, docker stop 6679 ms, exit code 137


  logs: até "3. Fim da drenagem"; o SIGKILL chegou antes do fim
Leitura: na ingênua, o /bin/sh era o PID 1 e o SIGTERM nunca chegou ao .NET (nenhum log de parada); o Docker esperou os 10 s e matou o contêiner, derrubando a requisição. Na otimizada, o SIGTERM chegou, o processo drenou, esperou a requisição terminar (HTTP 200 em 20,01 s) e saiu com código 0. Com -t 5, o prazo era menor que a requisição: SIGKILL. É o terminationGracePeriodSeconds do Kubernetes em miniatura.
Testes automatizados
Os testes não usam rede nem cluster: o WebApplicationFactory sobe a API em memória e o FakeDependencia substitui a dependência real. A fábrica:
using Microsoft.AspNetCore.Hosting;


using Microsoft.AspNetCore.Mvc.Testing;


using Microsoft.Extensions.DependencyInjection;


using Microsoft.Extensions.DependencyInjection.Extensions;


using Pedidos;


namespace Pedidos.Tests;


/// Dependencia falsa: o teste decide se ela esta no ar.


public sealed class FakeDependencia : IDependencia


{


    public volatile bool Ligada = true;


    public TimeSpan Atraso = TimeSpan.Zero;


    public async Task<bool> PingAsync(CancellationToken ct)


    {


        await Task.Delay(Atraso, ct);


        return Ligada;


    }


}


public sealed class AppFactory : WebApplicationFactory<Program>


{


    public FakeDependencia Dep { get; } = new();


    public int AquecimentoSegundos { get; init; }


    public bool UsaFake { get; init; } = true;


    protected override void ConfigureWebHost(IWebHostBuilder b)


    {


        b.UseSetting("Admin:Habilitado", "true");


        b.UseSetting("Shutdown:DrenagemSegundos", "0");


        b.UseSetting("Aquecimento:Segundos",


            AquecimentoSegundos.ToString());


        if (!UsaFake) return;


        b.ConfigureServices(s =>


        {


            s.RemoveAll<IDependencia>();


            s.AddSingleton<IDependencia>(Dep);


        });


    }


}
Três dos oito testes (readiness acompanha a dependência, o timeout e o shutdown que drena a readiness):
    [Fact]


    public async Task Ready_acompanha_a_dependencia()


    {


        _app.Dep.Ligada = true;


        Assert.Equal(Ok, await Status("/health/ready"));


        _app.Dep.Ligada = false;


        Assert.Equal(Fora, await Status("/health/ready"));


        _app.Dep.Ligada = true;


        Assert.Equal(Ok, await Status("/health/ready"));


    }


    [Fact]


    public async Task Ready_tem_timeout_se_a_dependencia_trava()


    {


        _app.Dep.Atraso = TimeSpan.FromSeconds(30);


        var r = await _http.GetAsync("/health/ready");


        _app.Dep.Atraso = TimeSpan.Zero;


        Assert.Equal(Fora, r.StatusCode);


        var corpo = await r.Content.ReadAsStringAsync();


        Assert.Contains("lenta", corpo);


} [Fact]
public async Task Shutdown_drena_a_readiness()
{
using var app = new AppFactory();
var http = app.CreateClient();
Assert.Equal(Ok, (await http.GetAsync("/health/ready"))
.StatusCode);
var drenagem = app.Services.GetServices<IHostedService>()
.OfType<Drenagem>().Single();
await drenagem.StoppingAsync(CancellationToken.None);
Assert.Equal(Fora, (await http.GetAsync("/health/ready"))
.StatusCode);
Assert.Equal(Ok, (await http.GetAsync("/health/live"))
.StatusCode);
}$ dotnet test Pedidos.slnx
Aprovado! - Com falha: 0, Aprovado: 8, Ignorado: 0, Total: 8Registro local, build e push, e o cluster kind
O passo "build and push" usa um registro local (o contêiner registry:2 em localhost:5001), sem conta em nuvem. O Docker aceita localhost como registro sem TLS:
docker run -d --name registro-local \


  -p 127.0.0.1:5001:5000 registry:2


docker tag pedidos:1.0 localhost:5001/pedidos:1.0


docker push localhost:5001/pedidos:1.0


curl -s localhost:5001/v2/_catalog


curl -s localhost:5001/v2/pedidos/tags/list1.0: digest: sha256:3a0d3276...4dde13 size: 856
{"repositories":["pedidos"]}
{"name":"pedidos","tags":["1.0"]}Num cenário real, o fluxo é o mesmo trocando o nome do registro. Não executei este trecho (exige uma assinatura Azure), é só a referência da documentação da Microsoft e da Docker:
az acr login --name meuregistro


docker tag pedidos:1.0 meuregistro.azurecr.io/pedidos:1.0


docker push meuregistro.azurecr.io/pedidos:1.0
O cluster nomeado artigo-k8s expõe a porta 30080 no localhost (para o cliente de carga). A configuração e o carregamento da imagem no nó, que dispensa o pull de um registro:
kind: Cluster


apiVersion: kind.x-k8s.io/v1alpha4


nodes:


  - role: control-plane


    extraPortMappings:


      - containerPort: 30080


        hostPort: 30080


listenAddress: "127.0.0.1"kind create cluster --name artigo-k8s \
--config k8s/kind-config.yaml
kind load docker-image pedidos:1.0 --name artigo-k8sSet kubectl context to "kind-artigo-k8s" (69 s no total)
NAME STATUS ROLES VERSION
artigo-k8s-control-plane Ready control-plane v1.37.0Os manifests
O Deployment, em três partes. Primeiro, réplicas, estratégia, o pod e a injeção de configuração (ConfigMap inteiro por envFrom, e o Secret em uma variável):
apiVersion: apps/v1


kind: Deployment


metadata:


  name: pedidos


  labels:


    app: pedidos


spec:


  replicas: 3


  revisionHistoryLimit: 3


  selector:


    matchLabels:


      app: pedidos


  strategy:


    type: RollingUpdate


    rollingUpdate:


      maxSurge: 1


      maxUnavailable: 0


  template:


    metadata:


      labels:


        app: pedidos


    spec:


      terminationGracePeriodSeconds: 40


      securityContext:


        runAsNonRoot: true


        seccompProfile:


          type: RuntimeDefault


      containers:


        - name: pedidos


          image: pedidos:1.0


          imagePullPolicy: IfNotPresent


          ports:


            - name: http


              containerPort: 8080


          envFrom:


            - configMapRef:


                name: pedidos-config


          env:


            - name: Api__Token


              valueFrom:


                secretKeyRef:


                  name: pedidos-segredo


                  key: token
Depois, recursos e segurança do contêiner: requests e limits, sem privilégios, sistema de arquivos raiz somente leitura (o emptyDir em /tmp cobre o que o runtime precisa gravar) e drop: ALL:
          resources:


            requests:


              cpu: 100m


              memory: 128Mi


            limits:


              cpu: 500m


              memory: 256Mi


          securityContext:


            allowPrivilegeEscalation: false


            readOnlyRootFilesystem: true


            capabilities:


              drop: ["ALL"]


          volumeMounts:


            - name: tmp


              mountPath: /tmp
Por fim, as três probes com os números justificados abaixo, o preStop e o volume:
          startupProbe:


            httpGet:


              path: /health/startup


              port: http


            periodSeconds: 2


            timeoutSeconds: 1


            failureThreshold: 30


          readinessProbe:


            httpGet:


              path: /health/ready


              port: http


            periodSeconds: 3


            timeoutSeconds: 3


            failureThreshold: 2


          livenessProbe:


            httpGet:


              path: /health/live


              port: http


            periodSeconds: 5


            timeoutSeconds: 2


            failureThreshold: 3


          lifecycle:


            preStop:


              sleep:


                seconds: 5


      volumes:


        - name: tmp


          emptyDir: {}
Por que esses números.
- startupProbe:
periodSeconds: 2×failureThreshold: 30dá 60 s para subir; o arranque medido leva 3 s (45 s no experimento lento). Margem grande, custo zero depois que passa. - readinessProbe:
3 s×2 falhastira o pod do Service em cerca de 6 s; otimeoutSeconds: 3é maior que o timeout interno da dependência (2 s), para o check responderUnhealthyem vez de a probe estourar. - livenessProbe:
5 s×3 falhascomtimeoutSeconds: 2reinicia um pod travado em 15 a 20 s. Mais agressivo que isso reinicia pods por um pico de GC. - preStop: o
sleepnativo do Kubernetes (lifecycle.preStop.sleep) dá tempo para o pod sair dos endpoints antes doSIGTERM. Em imagem chiseled não existe o bináriosleep, então oexec: sleepnão funcionaria. - terminationGracePeriodSeconds: 40 s, maior que
5 (preStop) + 3 (drenagem) + 25 (ShutdownTimeout).
O ConfigMap carrega as configurações por variável de ambiente (o __ vira : na configuração do .NET) e inclui o HostOptions__ShutdownTimeout:
apiVersion: v1


kind: ConfigMap


metadata:


  name: pedidos-config


data:


  ASPNETCORE_ENVIRONMENT: Production


  Aquecimento__Segundos: "3"


  Shutdown__DrenagemSegundos: "3"


  HostOptions__ShutdownTimeout: "00:00:25"


  Admin__Habilitado: "false"
O Secret tem um valor falso, só para mostrar o formato; em produção o valor vem de um cofre (Key Vault com o provedor CSI, External Secrets etc.) e nunca do Git:
# VALOR FALSO, so para o exemplo. Em producao o Secret vem de


# um cofre (Key Vault, External Secrets...), nunca do Git.


apiVersion: v1


kind: Secret


metadata:


  name: pedidos-segredo


type: Opaque


stringData:


  token: "valor-falso-de-exemplo"
Service ClusterIP, HPA e PodDisruptionBudget:
apiVersion: v1


kind: Service


metadata:


  name: pedidos


  labels:


    app: pedidos


spec:


  type: ClusterIP


  selector:


    app: pedidos


  ports:


    - name: http


      port: 80


targetPort: httpapiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: pedidos
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: pedidos
minReplicas: 3
maxReplicas: 6
metrics:
- type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 70
behavior:
scaleDown:
stabilizationWindowSeconds: 120apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
name: pedidos
spec:
minAvailable: 2
selector:
matchLabels:
app: pedidosA NetworkPolicy aceita entrada só na porta 8080, e a base se une no kustomization.yaml. O overlay dev ajusta namespace, configuração e expõe um NodePort:
apiVersion: networking.k8s.io/v1


kind: NetworkPolicy


metadata:


  name: pedidos


spec:


  podSelector:


    matchLabels:


      app: pedidos


  policyTypes: ["Ingress"]


  ingress:


    - ports:


        - port: 8080


protocol: TCPapiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization
namespace: pedidos-dev
resources:
- namespace.yaml
- ../../base
- service-nodeport.yaml
patches:
- path: config-dev.yaml
- path: replicas-dev.yaml# k8s/overlays/prod/kustomization.yaml (resumo)
namespace: pedidos-prod
resources: [namespace.yaml, ../../base, ingress.yaml]
images:
- name: pedidos
newName: meuregistro.azurecr.io/pedidos
newTag: "1.0"O Ingress do overlay prod e a NetworkPolicy foram validados só como YAML (o kubectl kustomize renderizou); não há Ingress Controller no cluster de teste.
Deploy e verificação (experimento b)
kubectl apply -k k8s/overlays/dev


kubectl -n pedidos-dev rollout status deploy/pedidos


kubectl -n pedidos-dev get pods


kubectl -n pedidos-dev get endpoints pedidosdeployment "pedidos" successfully rolled out
NAME READY STATUS RESTARTS AGE
pedidos-74cb498998-7fzt8 1/1 Running 0 7s
pedidos-74cb498998-8kdjq 1/1 Running 0 7s
pedidos-74cb498998-hn8vc 1/1 Running 0 7s
NAME ENDPOINTS
pedidos 10.244.0.5:8080,10.244.0.6:8080,10.244.0.7:8080Os três pods ficaram Ready em cerca de 7 s e o Service passou a ter três endpoints. O log em JSON, com a hora do evento, sai direto no kubectl logs:
{"Timestamp":"04:43:55.747 ","LogLevel":"Information",


 "Category":"Pedidos.Aquecimento",


 "Message":"Aquecendo cache por 3s"}
Experimentos de resiliência
(c) A dependência cai: a readiness falha e o pod sai do Service. O script faz port-forward para um pod específico, chama o endpoint admin que derruba a dependência e observa:
#!/usr/bin/env bash


# Experimento (c): dependencia cai -> readiness falha ->


# o pod sai do Service, sem reiniciar.


NS=pedidos-dev


POD=$(kubectl -n $NS get pod -l app=pedidos \


  -o jsonpath='{.items[0].metadata.name}')


kubectl -n $NS port-forward "pod/$POD" 18080:8080 >/dev/null &


PF=$!; sleep 2


echo "== antes"; kubectl -n $NS get endpoints pedidos


curl -s -XPOST localhost:18080/admin/dependencia/false; echo


sleep 8


echo "== depois (pod alvo: $POD)"


kubectl -n $NS get pods -l app=pedidos


kubectl -n $NS get endpoints pedidos


curl -s localhost:18080/health/ready; echo


curl -s -o /dev/null -w 'live=%{http_code}\n' \


  localhost:18080/health/live


kubectl -n $NS get events --field-selector reason=Unhealthy \


  | tail -3


curl -s -XPOST localhost:18080/admin/dependencia/true; echo


sleep 6


echo "== recuperado"; kubectl -n $NS get endpoints pedidos


kill $PF== antes
pedidos 10.244.0.5:8080,10.244.0.6:8080,10.244.0.7:8080
== depois (pod alvo: pedidos-74cb498998-7fzt8)
pedidos-74cb498998-7fzt8 0/1 Running 0 31s
pedidos-74cb498998-8kdjq 1/1 Running 0 31s
pedidos-74cb498998-hn8vc 1/1 Running 0 31s
pedidos 10.244.0.5:8080,10.244.0.7:8080
{"status":"Unhealthy","checks":[{"nome":"dependencia",
"status":"Unhealthy","detalhe":"dependencia fora do ar"}]}
live=200
== recuperado (6 s depois de religar)
pedidos 10.244.0.5:8080,10.244.0.6:8080,10.244.0.7:8080
O pod alvo ficou 0/1, sumiu dos endpoints (3 IPs para 2) e não reiniciou (RESTARTS 0): /health/live continuou 200. É o comportamento desejado: uma dependência fora do ar não justifica reiniciar o processo, só tirá-lo de circulação. Quando a dependência voltou, o IP retornou aos endpoints sozinho.
(d) A aplicação trava: a liveness reinicia o contêiner. O POST /admin/travar faz o VivoCheck esperar para sempre (um deadlock simulado):
#!/usr/bin/env bash


# Experimento (d): a aplicacao trava -> liveness falha 3x ->


# o kubelet reinicia o container (restartCount sobe).


NS=pedidos-dev


POD=$(kubectl -n $NS get pod -l app=pedidos \


  -o jsonpath='{.items[0].metadata.name}')


kubectl -n $NS port-forward "pod/$POD" 18080:8080 >/dev/null &


PF=$!; sleep 2


echo "== travando $POD"


curl -s -XPOST localhost:18080/admin/travar; echo


for i in $(seq 1 9); do


  sleep 4


  kubectl -n $NS get pod "$POD" --no-headers -o custom-columns=\


POD:.metadata.name,\


READY:.status.containerStatuses[0].ready,\


RESTARTS:.status.containerStatuses[0].restartCount


done


kill $PF


kubectl -n $NS describe pod "$POD" | grep -E \


  'Liveness|Last State|Reason|Exit Code|Restart Count'


kubectl -n $NS get events --sort-by=.lastTimestamp \


| grep "$POD" | grep -E 'Unhealthy|Killing|Started' | tail -5POD READY RESTARTS
pedidos-74cb498998-7fzt8 true 0 (5 leituras iguais)
pedidos-74cb498998-7fzt8 false 1
pedidos-74cb498998-7fzt8 true 1
Warning Unhealthy Liveness probe failed: Get ".../health/live":
context deadline exceeded (Client.Timeout exceeded ...)
Last State: Terminated Reason: Completed Exit Code: 0
O restartCount foi de 0 para 1 em cerca de 20 s (três falhas por timeout de 2 s, a cada 5 s). O contêiner anterior terminou com exit code 0: o kubelet envia SIGTERM e o desligamento gracioso funcionou mesmo no reinício.
(e) Arranque lento: a startupProbe protege. Com Aquecimento__Segundos=45 e Aquecimento__Bloqueante=true, o Kestrel só abre a porta após 45 s. Duas variações, rodando scripts/exp-e-startup.sh com e sem (o sem aplica o patch k8s/experimentos/sem-startup-probe.yaml, que remove a startupProbe e deixa só initialDelaySeconds: 5 na liveness):
COM startupProbe (restartCount sempre 0):


t=40s  pedidos-69679659d5-2plhv  0/1  Running  restarts=0


t=45s  pedidos-69679659d5-2plhv  1/1  Running  restarts=0


       (o pod antigo só sai depois do novo ficar Ready)


SEM startupProbe (liveness com initialDelay 5 s):


t=10s  pedidos-57fdf87f99-7p48t  0/1  Running  restarts=0


t=25s  pedidos-57fdf87f99-7p48t  0/1  Running  restarts=1


t=40s  pedidos-57fdf87f99-7p48t  0/1  Running  restarts=2


t=55s  pedidos-57fdf87f99-7p48t  0/1  Running  restarts=3


Warning  Unhealthy  Liveness probe failed ... connection refused


Normal   Killing    Container pedidos failed liveness probe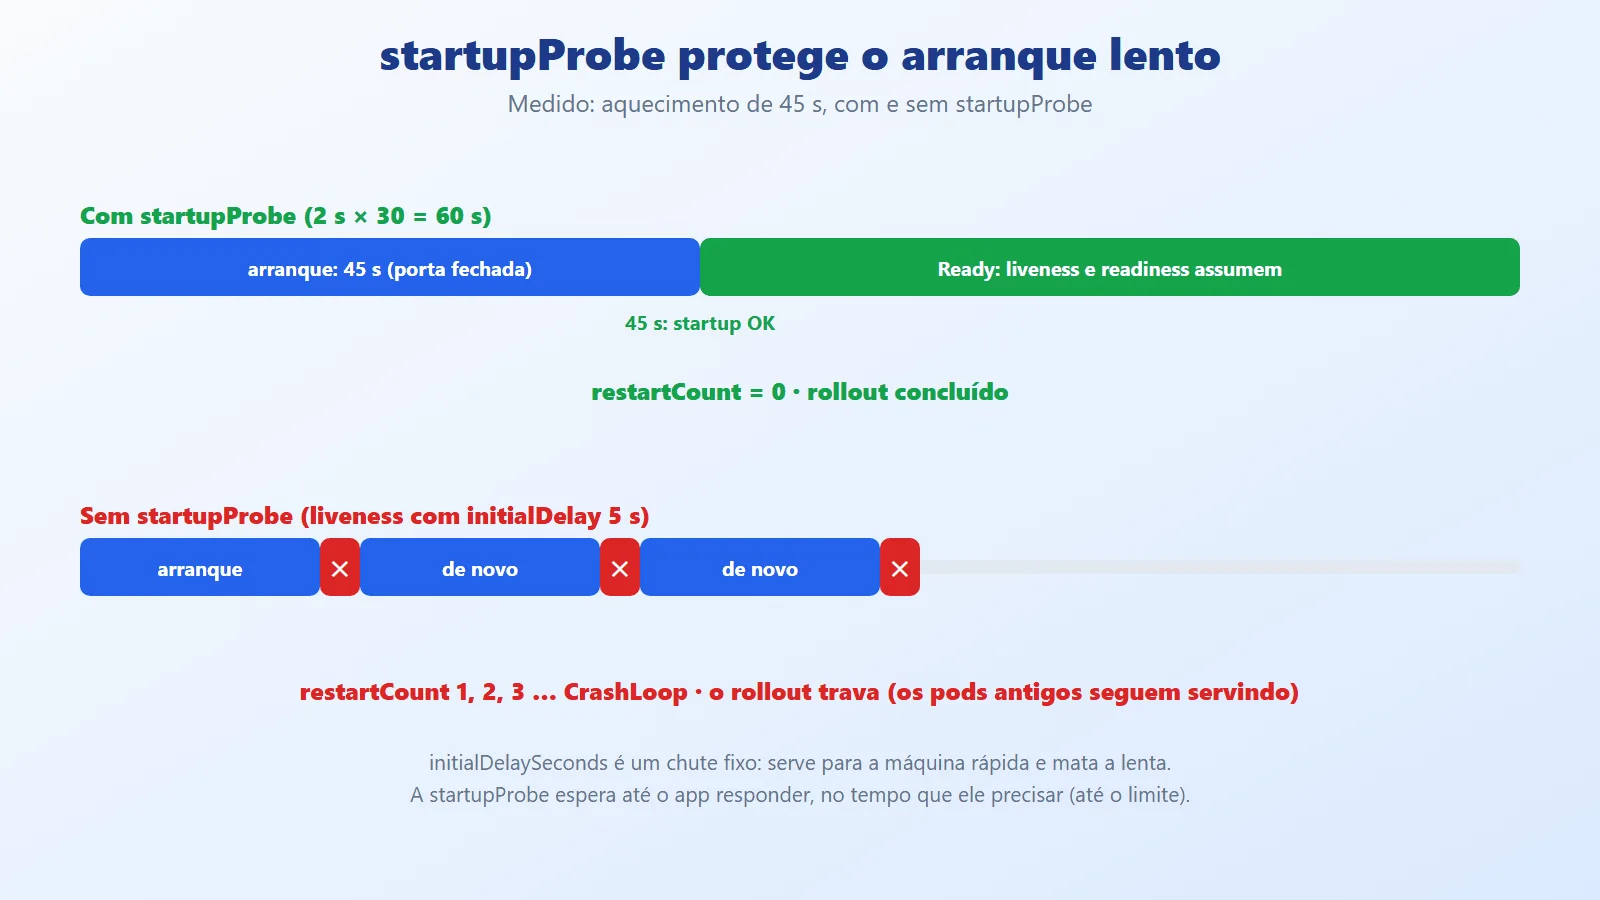
Sem a startupProbe, a liveness começou a bater aos 5 s numa porta ainda fechada e matou o contêiner a cada ~15 s, em crash loop; o rollout travou, mas os 3 pods antigos continuaram atendendo (efeito do maxUnavailable: 0). Com a startupProbe, o Kubernetes esperou os 45 s sem reiniciar nada.
(f) Rolling update sob carga contínua. O cliente tools/Carga dispara 10 laços de GET /info pelo NodePort durante 45 s e conta status e pods; aos 8 s o script faz rollout restart:
dotnet run -c Release --project tools/Carga -- \


  http://localhost:30080/info 45 &


sleep 8


kubectl -n pedidos-dev rollout restart deploy/pedidosCOM preStop (5 execuções, 55,8 mil requisições):
200: 13452 200: 12774 200: 9420 200: 10680 200: 9467
erros: 0 em todas
SEM preStop e SEM drenagem (6 execuções, 78 mil requisições):
200: 13375 HttpRequestException: 2 <- 1 execução
200: 13167 200: 12702 200: 12591 200: 13273 200: 12908
erros: 0 nas outras 5Resultado honesto: nas 5 execuções com preStop, zero erros. Sem a proteção, 5 das 6 execuções também fecharam sem erros e uma teve 2 HttpRequestException em 13 mil requisições. Uma ressalva de método: em 2 das 5 execuções "com", a drenagem herdou o valor 0 de uma execução anterior (variável de ambiente que o apply -k não remove); só o preStop estava ativo, e mesmo assim não houve erro. A janela de erro existe (requisição roteada para um pod cujo Kestrel já fechou), mas num cluster de um nó só, com a propagação dos endpoints quase instantânea, ela é estreita. Num cluster real, com vários nós e kube-proxy ou Ingress demorando mais para atualizar, ela é maior. O experimento mostra a proteção sem erros, mas não a provou com a frequência de um cluster grande; por isso o artigo não promete 100%.
(g) kubectl delete pod com requisição lenta em voo.
curl 'localhost:30080/lento?segundos=25' &     # em voo


kubectl -n pedidos-dev delete pod $ALVO --wait=falsepod com a requisição em voo: pedidos-86c5644686-d6v5b
{"concluido":true,"pod":"pedidos-86c5644686-d6v5b"}
http=200 em 25.25s
04:35:06.519 1. Stopping (SIGTERM) <- 5 s após o delete
04:35:06.522 2. Drenando (readiness 503) 3s
04:35:09.523 3. Fim da drenagem, fechando
04:35:18.610 4. Stopped <- requisição concluídaO pod foi apagado com a requisição de 25 s ainda correndo e a resposta chegou, com HTTP 200 e o nome do pod que a atendeu. O SIGTERM veio 5 s depois do delete (o preStop), a drenagem durou 3 s e o processo saiu quando a última requisição terminou.
(h) PodDisruptionBudget barra a segunda eviction. O kubectl drain usa a API de eviction, que respeita o PDB (minAvailable: 2 com 3 réplicas). O kind tem um só nó (esvaziá-lo derrubaria o próprio plano de controle), então chamei a API de eviction diretamente:
NAME      MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS


pedidos   2               N/A               1


== evict pedidos-785ffbd8ff-8w2sq


{"kind":"Status",...,"status":"Success","code":201}


pedidos   2     N/A   0


== evict pedidos-785ffbd8ff-c8rt5


Error from server (TooManyRequests): Cannot evict pod as it


would violate the pod's disruption budget.
A primeira eviction passou (1 disrupção permitida) e a segunda, imediata, foi recusada com 429 até o pod substituto ficar Ready. Uma manutenção de nó que respeite o PDB nunca deixa o serviço abaixo de 2 pods.
O que o .NET enxerga do contêiner (limites de recurso)
O /info mostra o que o runtime lê do cgroup. Rodando a mesma imagem com limites diferentes no Docker, e depois no pod (cpu: 500m, memory: 256Mi):
limites                    cpus  memMb  gcServidor  threads


(nenhum)                     12  15823  true             12


--cpus 2 --memory 512m        2    384  true              2


--cpus 4 --memory 1g          4    768  true              4


--cpus 0.5 --memory 128m      1     96  false             1


pod: 500m / 256Mi             1    192  false             1
O limite de CPU arredondado para cima vira ProcessorCount (e o mínimo de threads do ThreadPool); o limite de memória vira o teto do GC em 75%. Com menos de 2 CPUs, o GC servidor é desligado. Dois cuidados que saem disso: um limits.cpu menor que 1 core faz o .NET achar que tem 1 núcleo (e o throttling do cgroup segura o resto), e um limits.memory apertado demais causa OOMKilled em vez de GC mais agressivo.
Resumo medido e o que não foi executado
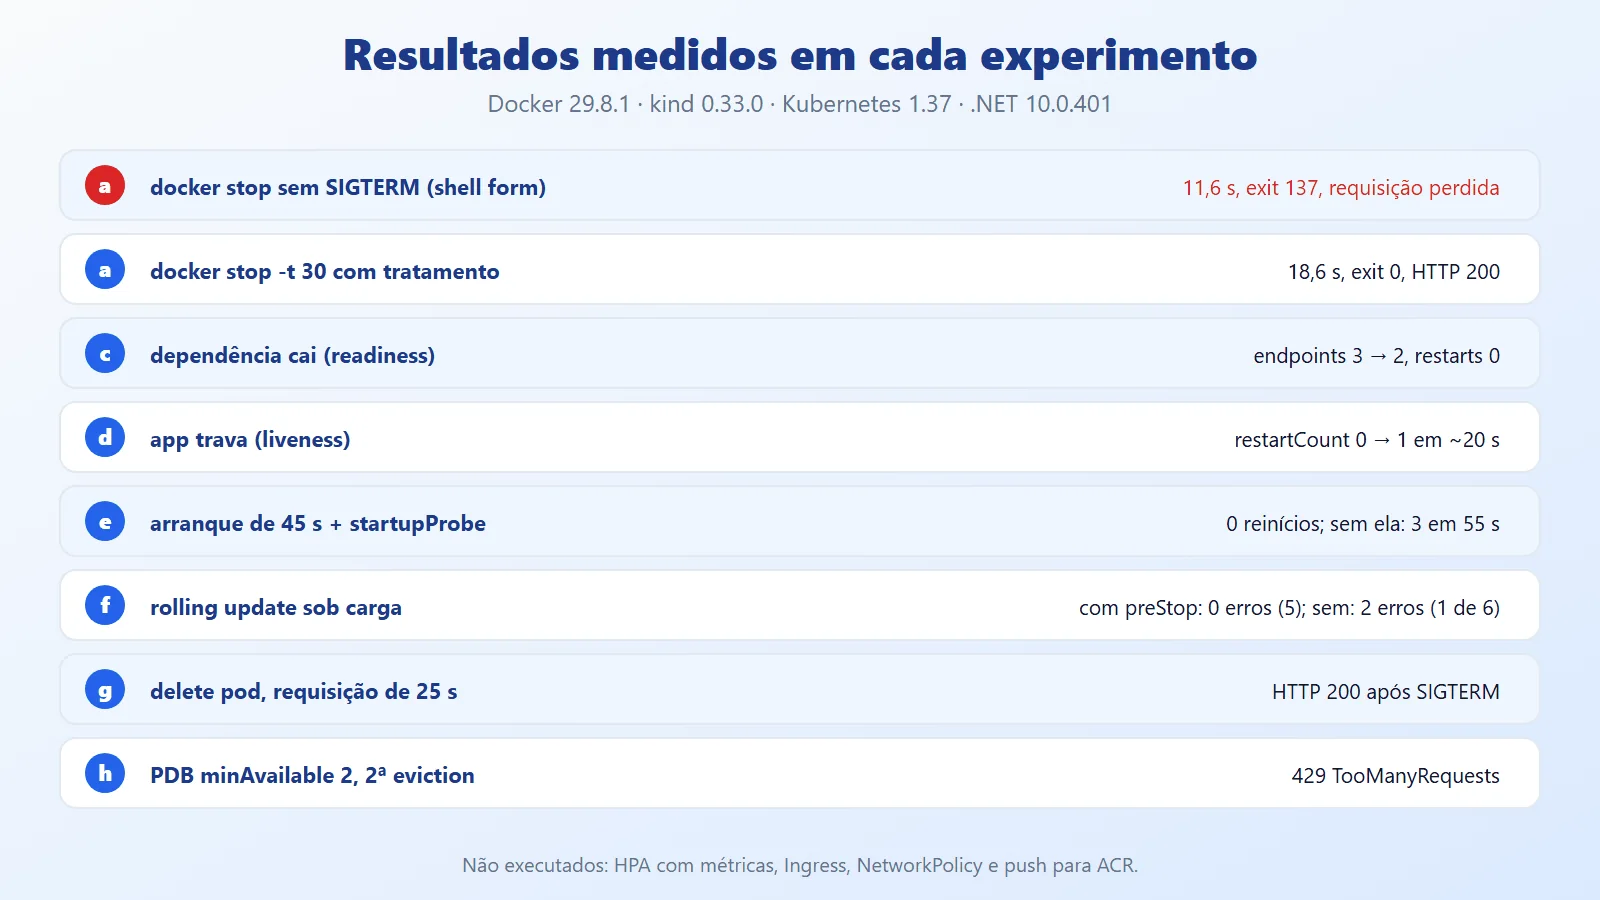
Não executado: o HPA ficou aplicado, mas com cpu: <unknown>/70% porque o kind não traz o metrics-server (instalá-lo exige baixar outro manifesto e ajustar TLS, fora do que foi autorizado); a escala automática, portanto, não foi observada. O Ingress e a NetworkPolicy foram só renderizados (sem Ingress Controller, e a aplicação efetiva da política não foi testada); o push para um ACR real foi descrito, não executado; as métricas Prometheus/OpenTelemetry ficaram de fora para manter o exemplo enxuto.
Boas práticas de Kubernetes para .NET: probes e segurança

Erros comuns de probe (erro vs correção)
Liveness que checa o banco. Quando o banco cai, a liveness falha em todos os pods ao mesmo tempo e o Kubernetes reinicia a frota inteira, sem resolver nada (o banco continua fora). Correção: a liveness olha só o processo; a dependência vai na readiness.
// ERRADO: a liveness depende do banco


.AddCheck("banco", () => PingBanco(), tags: ["live"])


// CERTO: a dependência fica na readiness


.AddCheck<VivoCheck>("vivo", tags: ["live"])


.AddCheck<ProntoCheck>("dependencia", tags: ["ready"])
Readiness sem timeout. Se o ping à dependência não tem limite, a probe fica pendurada até o timeoutSeconds e o resultado vira "falha de probe" genérica. Correção: um timeout menor dentro do check, com mensagem clara (o teste Ready_tem_timeout_se_a_dependencia_trava cobre isso):
// ERRADO: espera o quanto a dependência quiser


var ok = await dependencia.PingAsync(ct);


// CERTO: limita a espera a 2 s


cts.CancelAfter(TimeSpan.FromSeconds(2));


var ok = await dependencia.PingAsync(cts.Token);
initialDelaySeconds no lugar da startupProbe. O atraso fixo serve para a máquina rápida e mata a lenta (experimento (e)). Correção: a startupProbe com margem generosa; a liveness e a readiness sem initialDelaySeconds:
# ERRADO: um chute fixo para o arranque


livenessProbe:


  httpGet: { path: /health/live, port: http }


  initialDelaySeconds: 5


# CERTO: esperar o app avisar que subiu


startupProbe:


  httpGet: { path: /health/startup, port: http }


  periodSeconds: 2


  failureThreshold: 30
A mesma rota para as três probes. Um único /health que checa tudo mistura as perguntas: uma dependência lenta passa a reiniciar o pod. Correção: um endpoint por pergunta, como em Saude.Rota("live"), ("ready") e ("startup").
Sem preStop nem drenagem. O pod recebe SIGTERM e fecha a porta enquanto ainda está nos endpoints de alguns nós. Correção: preStop com sleep e a readiness devolvendo 503 ao receber o sinal:
# ERRADO: o pod fecha assim que recebe o SIGTERM


terminationGracePeriodSeconds: 30


# CERTO: sai do Service, espera, só então termina


terminationGracePeriodSeconds: 40


lifecycle:


  preStop:


    sleep:


      seconds: 5
Imagem e segurança
- Use
USER $APP_UID(numérico) erunAsNonRoot: true: com um nome de usuário (USER app) o kubelet não consegue verificar o UID e rejeita o pod. readOnlyRootFilesystem: truecom umemptyDirem/tmp;allowPrivilegeEscalation: false;capabilities.drop: ["ALL"];seccompProfile: RuntimeDefault. Os Pod Security Standards (perfil restricted) pedem exatamente isso.- Porta 8080, não 80: usuário sem privilégio não abre portas abaixo de 1024. O
ASPNETCORE_HTTP_PORTS=8080é o ajuste do .NET 8 em diante. - Imagem chiseled não tem shell:
kubectl exec ... -- shfalha (testei). Para depurar, use logs,kubectl debugcom um contêiner efêmero oudotnet-monitor.
$ kubectl -n pedidos-dev exec $POD -- sh


error: ... failed to exec in container: failed to start exec ...
Shutdown: some os tempos
A regra é preStop + drenagem + ShutdownTimeout < terminationGracePeriodSeconds. Se a soma passar do prazo, o SIGKILL corta requisições. O HostOptions.ShutdownTimeout (padrão de 30 s) é configurável por variável de ambiente, e pode ser menor que o prazo do pod:
# ConfigMap


HostOptions__ShutdownTimeout: "00:00:25"


Shutdown__DrenagemSegundos: "3"
Requisições maiores que o ShutdownTimeout são abortadas na parada; se o seu caso tem trabalho longo, mova-o para uma fila e processe-o fora do ciclo da requisição.
Configuração, segredos e limites
- ConfigMap para o que não é sigiloso; Secret para o que é. O Secret do Kubernetes é só base64: restrinja o RBAC e prefira um cofre externo.
- Mudar um ConfigMap não reinicia o pod. Para recarregar variáveis de ambiente, faça
kubectl rollout restart(ou use um hash do conteúdo no nome do ConfigMap, como o KustomizeconfigMapGenerator). requests≈ uso típico;limits≥ pico. Memória sem limite arrisca derrubar o nó; CPU com limite justo gera throttling (veja a seção 4.11).- Logs em JSON no stdout, uma linha por evento; o coletor do cluster cuida do resto. Nada de arquivo de log dentro do contêiner (o sistema de arquivos é somente leitura).
Produção
- HPA precisa do metrics-server e de
requestsde CPU definidos; definaminReplicas≥ ominAvailabledo PDB. - PDB com
minAvailableigual ao número de réplicas bloqueia todas as manutenções; deixe pelo menos uma disrupção permitida. - Imagens por digest (
@sha256:...) ou tags imutáveis; nuncalatest. OimagePullPolicy: Alwaysdo overlayprodsó faz sentido com tags imutáveis. - Resiliência dentro da app continua necessária: retry, circuit breaker e timeout ficam no cliente, como na série (Tolerância a Falhas vs Resiliência). As probes cuidam do ciclo de vida do pod, não da chamada que falhou.
- Admin e health: os
/admin/*do exemplo existem só no overlaydev; as rotas/health/*não devem expor detalhes internos fora do cluster.
Quando usar Kubernetes para APIs .NET e quando evitar
Quando usar este conjunto (probes + graceful shutdown + manifests declarativos):
- Serviços HTTP stateless com mais de uma réplica, com deploys frequentes e meta de zero downtime.
- Dependências externas que oscilam (banco, fila, API de terceiros): a readiness absorve a oscilação sem reiniciar.
- Equipes que precisam de ambientes parecidos (dev/homologação/produção) com diferenças pequenas e revisáveis (Kustomize).
Quando evitar ou simplificar:
- Um app pequeno, uma réplica, sem deploy frequente: um App Service ou Container Apps (ou até uma VM) custa menos esforço que operar um cluster. O Kubernetes cobra manutenção própria.
- Workloads com estado forte (banco, fila): prefira o serviço gerenciado;
StatefulSete volumes aumentam a complexidade. - Jobs curtos e batch: use
Job/CronJob; probes de liveness e readiness não fazem sentido para um processo que roda e termina. - Liveness agressiva "por precaução": ela reinicia pods saudáveis em picos. Se não há um caso real de travamento, uma liveness simples (ou nenhuma, mantendo startup e readiness) é mais segura.
Comparando com as alternativas: Azure Container Apps e App Service já trazem probes e rollout e escondem o YAML; o Kubernetes dá controle total do ciclo de vida (como visto aqui) em troca de mais responsabilidade. A escolha depende do quanto você precisa desse controle.
Kubernetes com .NET: probes, imagem enxuta e shutdown
Uma imagem chiseled multi-stage reduziu o contêiner de 1,3 GB para 180 MB, sem shell e sem root. Três endpoints, cada um com uma pergunta, deram ao Kubernetes as respostas certas: a startup protege o arranque lento (0 reinícios contra 3 em 55 s), a readiness tira o pod do Service sem reiniciar (3 endpoints para 2) e a liveness reinicia só o que travou (restartCount 0 para 1 em ~20 s). No desligamento, preStop + drenagem + ShutdownTimeout dentro do terminationGracePeriodSeconds fizeram uma requisição de 25 s terminar com HTTP 200 mesmo com o pod apagado, e o PDB barrou a segunda eviction seguida.
A reflexão prática: probe não é detalhe de YAML, é parte do contrato entre a aplicação e o orquestrador. Cada número (period, timeout, failureThreshold, os tempos de desligamento) tem uma consequência medível; teste-os como testa o código (o repositório traz 8 testes sem cluster e 7 scripts de experimento). E seja honesto com a medição: neste cluster de um nó, o preStop reduziu mas não "provou" a eliminação dos erros do rolling update; em produção, a diferença só aparece com carga real. Comece pela liveness simples, a readiness com timeout e a startup generosa; ajuste depois com dados.
Referências e links sobre Kubernetes com .NET
- Código do artigo (repositório): https://github.com/ceseidl/kubernetes-dotnet
- Microsoft Learn, contêineres .NET: https://learn.microsoft.com/dotnet/core/docker/introduction
- Microsoft Learn, publicar como contêiner (
PublishContainer): https://learn.microsoft.com/dotnet/core/docker/publish-as-container - Microsoft Learn, health checks no ASP.NET Core: https://learn.microsoft.com/aspnet/core/host-and-deploy/health-checks
- Microsoft Learn, Generic Host e shutdown: https://learn.microsoft.com/aspnet/core/fundamentals/host/generic-host
- Microsoft Learn, configuração do GC (limites de contêiner): https://learn.microsoft.com/dotnet/core/runtime-config/garbage-collector
- Imagens chiseled (documentação do dotnet-docker): https://github.com/dotnet/dotnet-docker/blob/main/documentation/ubuntu-chiseled.md
- Anúncio das imagens chiseled: https://devblogs.microsoft.com/dotnet/announcing-dotnet-chiseled-containers/
- Kubernetes, probes de liveness, readiness e startup: https://kubernetes.io/docs/tasks/configure-pod-container/configure-liveness-readiness-startup-probes/
- Kubernetes, ciclo de vida do pod e término: https://kubernetes.io/docs/concepts/workloads/pods/pod-lifecycle/
- Kubernetes, ganchos do ciclo de vida (
preStop): https://kubernetes.io/docs/concepts/containers/container-lifecycle-hooks/ - Kubernetes, Deployment e rolling update: https://kubernetes.io/docs/concepts/workloads/controllers/deployment/
- Kubernetes, PodDisruptionBudget: https://kubernetes.io/docs/tasks/run-application/configure-pdb/
- Kubernetes, HPA: https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/
- Kubernetes, Kustomize: https://kubernetes.io/docs/tasks/manage-kubernetes-objects/kustomization/
- Kubernetes, Secrets: https://kubernetes.io/docs/concepts/configuration/secret/
- Kubernetes, Pod Security Standards: https://kubernetes.io/docs/concepts/security/pod-security-standards/
- Kubernetes, NetworkPolicy: https://kubernetes.io/docs/concepts/services-networking/network-policies/
- kind, guia rápido: https://kind.sigs.k8s.io/docs/user/quick-start/
- kind, registro local: https://kind.sigs.k8s.io/docs/user/local-registry/
- Docker Desktop no Windows: https://docs.docker.com/desktop/setup/install/windows-install/
- WSL: https://learn.microsoft.com/windows/wsl/install
- .NET 10 SDK: https://dotnet.microsoft.com/download/dotnet/10.0
Leia também
- Tolerância a Falhas vs Resiliência em .NET: aprofunda timeout, retry e circuit breaker, além dos probes do cluster.
- Rate Limiting em .NET: protege a API que você acabou de colocar no ar contra picos de tráfego.
- Evite DateTime.Now em produção .NET 10: cuidado com fuso e UTC em contêineres que vale revisar antes do deploy.
Quer uma revisão da arquitetura do seu backend .NET? Conheça o serviço de backend e arquitetura .NET.