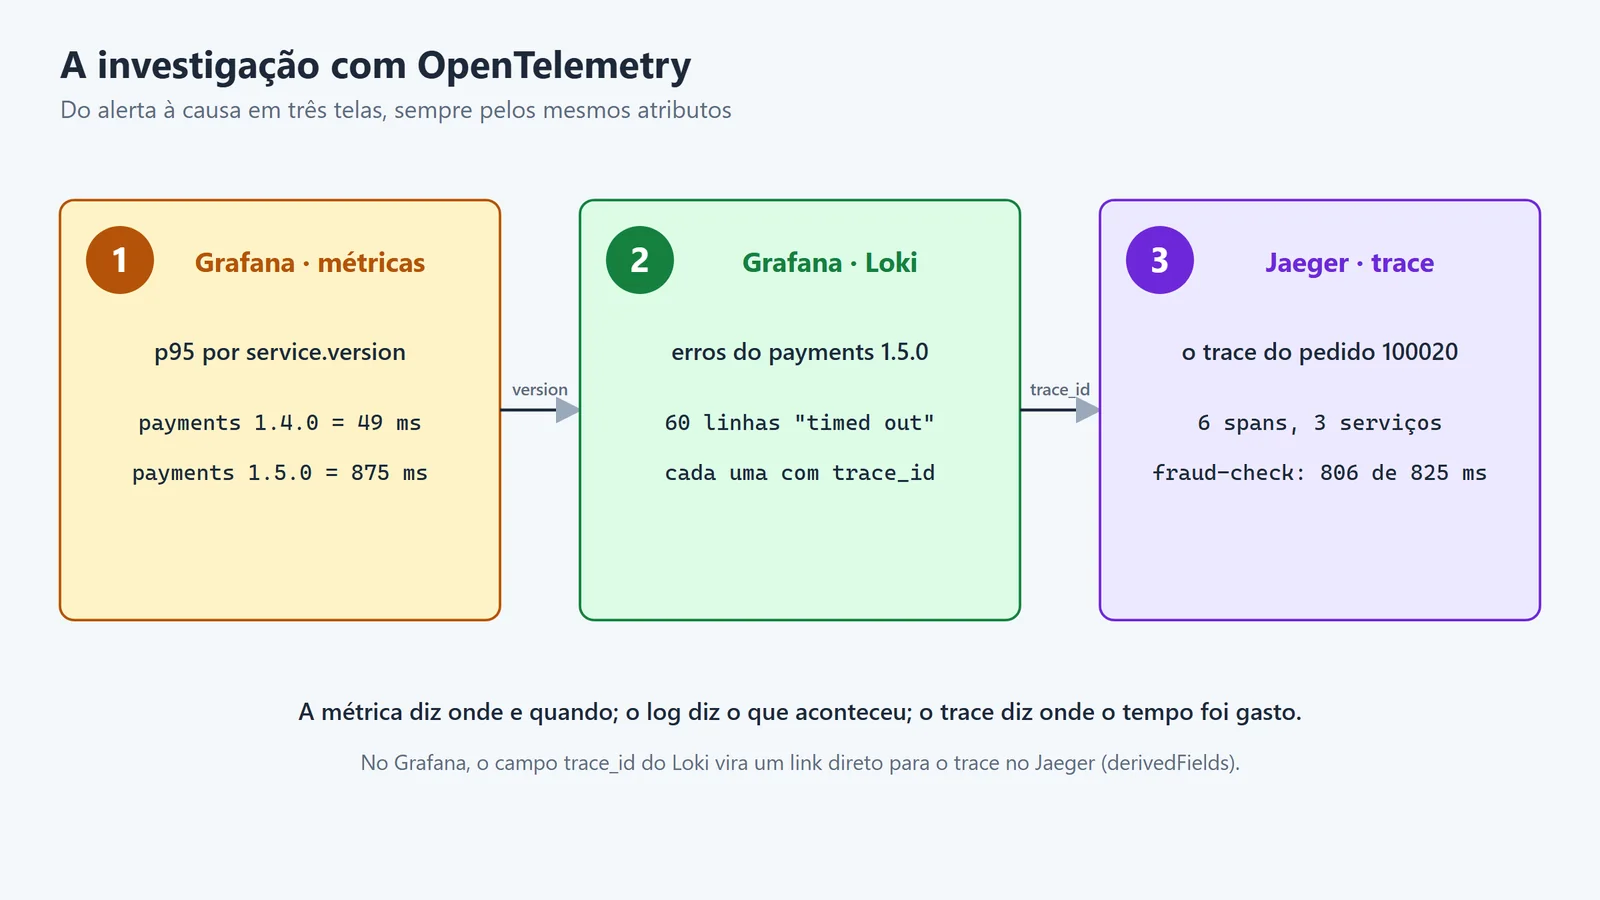
Para levar logs, métricas e traces de uma API .NET a ferramentas de verdade, você configura o SDK do OpenTelemetry uma vez por serviço: um Resource com nome e versão, as instrumentações do ASP.NET Core e do HttpClient, as suas fontes de spans e métricas e um único exporter OTLP. Os sinais vão para o OpenTelemetry Collector, que manda os traces ao Jaeger, as métricas ao Prometheus e os logs ao Loki, e o Grafana mostra tudo junto. Neste artigo, em .NET 10, eu repito o incidente do artigo anterior com essa stack completa. O painel mostra o p95 do payments indo de 49 ms para 875 ms na versão 1.5.0, o Loki mostra as 60 linhas de erro com o trace id, e o Jaeger mostra que 806 dos 825 ms foram gastos na verificação antifraude. No caminho, o próprio painel pegou um erro meu: um histograma com buckets na unidade errada.
Do console ao backend de verdade
No artigo anterior, eu segui um incidente pelos três sinais lendo tudo com ActivityListener e MeterListener, sem pacote nenhum, e imprimindo no console. Serviu para mostrar o mecanismo. Em produção, ninguém investiga incidente no console: os sinais precisam sair do processo, ser guardados e ser consultados juntos.
É isso que o OpenTelemetry resolve. Ele é um padrão aberto, com SDK para .NET, um protocolo próprio (OTLP) e um Collector que recebe os sinais e os entrega ao backend que você escolher. O código continua usando as APIs do próprio .NET (ActivitySource, Meter, ILogger); o SDK só coleta e exporta.
Os três serviços são os mesmos: gateway, orders e payments, com o mesmo defeito na versão 1.5.0 do payments (em 10% dos pedidos a verificação antifraude leva 800 ms, e em metade desses responde 502). A diferença é que agora cada serviço roda no seu processo, como em produção, e manda os sinais para esta stack:

As condições: .NET 10 (SDK 10.0.402), OpenTelemetry .NET 1.20.1, Collector 0.164.0, Jaeger 2.22.0, Prometheus 3.15.1, Loki 3.7.9 e Grafana 13.2.4, tudo numa só máquina com Docker. O programa de demonstração manda 20 checkouts por segundo durante 60 segundos com o payments 1.4.0, troca para a 1.5.0 e manda mais 60 segundos. Os atrasos continuam simulados.
Quatro pacotes e uma chamada por serviço
O projeto usa quatro pacotes do OpenTelemetry, todos do nuget.org:
<ItemGroup>
  <PackageReference
    Include="OpenTelemetry.Exporter.OpenTelemetryProtocol"
    Version="1.20.1" />
  <PackageReference
    Include="OpenTelemetry.Extensions.Hosting"
    Version="1.20.1" />
  <PackageReference
    Include="OpenTelemetry.Instrumentation.AspNetCore"
    Version="1.20.1" />
  <PackageReference
    Include="OpenTelemetry.Instrumentation.Http"
    Version="1.20.1" />
</ItemGroup>
A configuração inteira cabe num método de extensão, chamado por cada serviço com o seu nome e a sua versão:
public static void AddShopTelemetry(
    this WebApplicationBuilder builder,
    string name, string version)
{
    builder.Logging.ClearProviders();

    builder.Services.AddOpenTelemetry()
        .ConfigureResource(r => r.AddService(
            serviceName: name,
            serviceVersion: version))
        .WithTracing(t => t
            .AddAspNetCoreInstrumentation(o =>
                o.Filter = ctx =>
                    ctx.Request.Path != "/health")
            .AddHttpClientInstrumentation()
            .AddSource(Payments.Source.Name))
        .WithMetrics(m => m
            .AddAspNetCoreInstrumentation()
            .AddHttpClientInstrumentation()
            .AddMeter(Payments.Meter.Name))
        .WithLogging(
            configureBuilder: null,
            configureOptions: o =>
                o.IncludeFormattedMessage = true)
        .UseOtlpExporter();
}
Cada linha tem um papel:
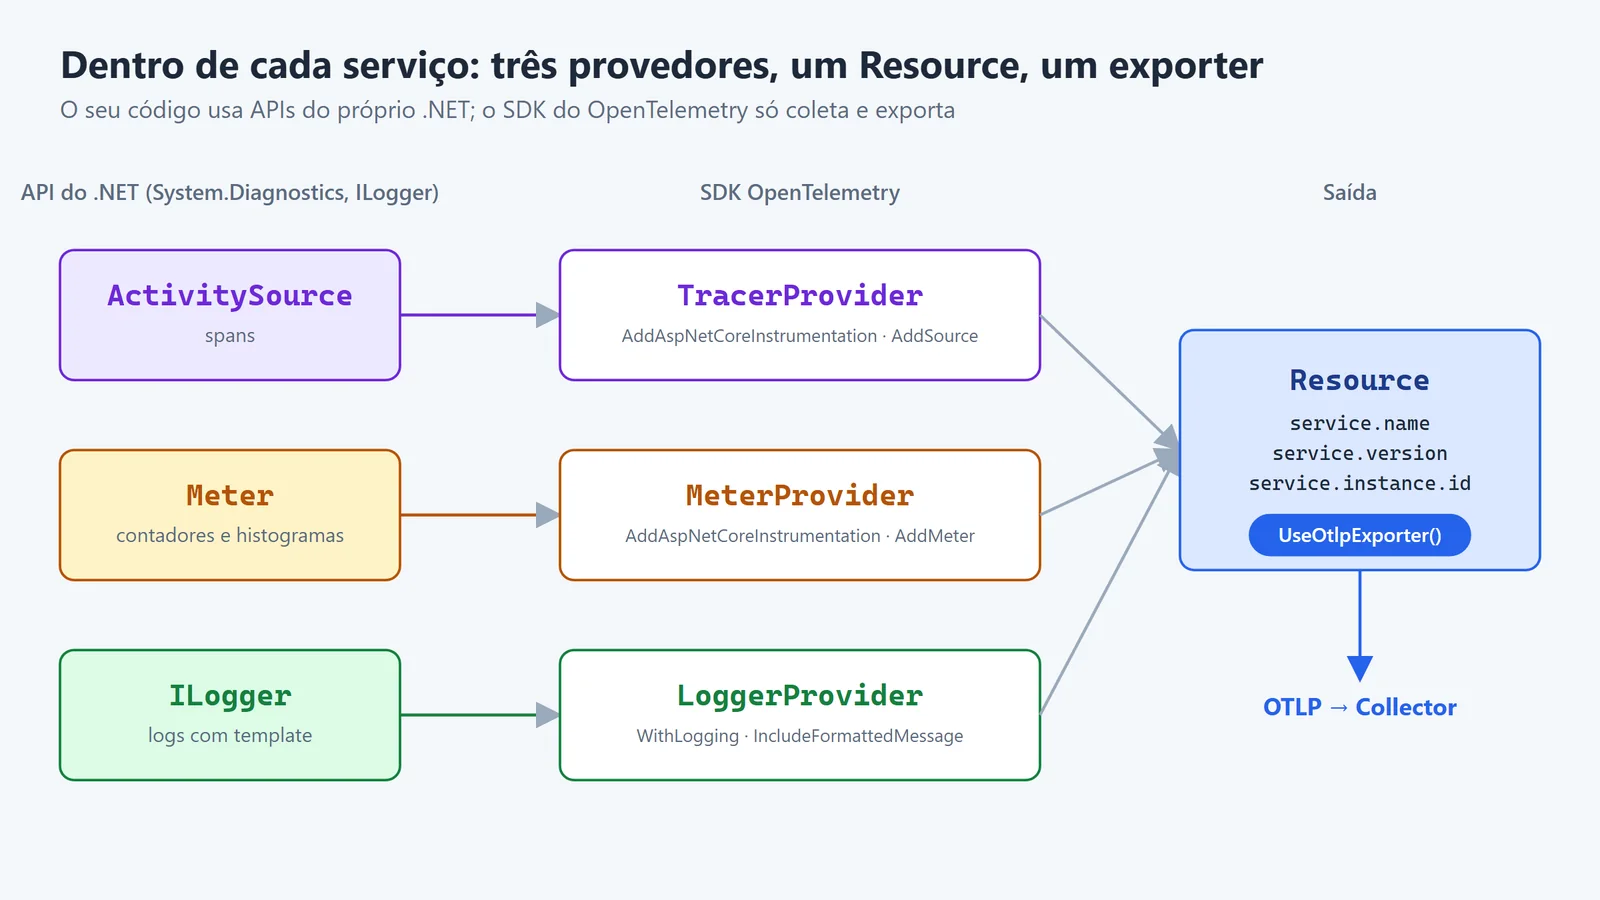
ConfigureResourcedefine o Resource:service.nameeservice.versionvão junto com todos os spans, séries de métrica e linhas de log desse processo. O SDK acrescenta sozinho umservice.instance.id.WithTracingliga os spans do ASP.NET Core e do HttpClient e a minha fonteShop.Payments. OFiltertira o/healthdos traces, para a checagem de saúde não poluir a busca.WithMetricsliga as métricas do ASP.NET Core, comohttp.server.request.duration, e o meuMeter.WithLoggingleva oILoggerpara o OpenTelemetry. O trace id e o span id entram em cada log sem nenhum código meu.UseOtlpExportermanda os três sinais por OTLP. Sem configuração, o destino élocalhost:4317; em outro ambiente, a variávelOTEL_EXPORTER_OTLP_ENDPOINTmuda isso sem recompilar.
Por dentro, cada serviço fica assim:
Spans, métricas e logs do seu próprio código
As instrumentações cobrem as fronteiras: requisição recebida, chamada HTTP feita. O que acontece dentro do payments precisa de instrumentação minha. Ela continua usando só APIs do .NET, ActivitySource e Meter:
public static readonly ActivitySource Source =
    new("Shop.Payments");
public static readonly Meter Meter = new("Shop.Payments");

// Without advice, the SDK uses buckets made for
// milliseconds (5, 10, 25...), and every value in
// seconds lands in the first one.
static readonly Histogram<double> FraudCheck =
    Meter.CreateHistogram<double>(
        "payments.fraud_check.duration", unit: "s",
        description: null, tags: null,
        advice: new InstrumentAdvice<double>
        {
            HistogramBucketBoundaries =
                [0.01, 0.025, 0.05, 0.1, 0.25,
                 0.5, 0.75, 1, 2.5],
        });
O comentário sobre os buckets não estava lá na primeira versão. Ele tem uma história, que aparece mais adiante.
Na verificação antifraude, o mesmo trecho cria o span, registra a duração no histograma e escreve o log:
using (var span = Source.StartActivity("fraud-check"))
{
    span?.SetTag("order.id", id);
    await Task.Delay(bug ? 800 : 20);

    if (bug && id % 20 == 0)
    {
        span?.SetStatus(
            ActivityStatusCode.Error, "timeout");
        FraudCheck.Record(clock.Elapsed.TotalSeconds,
            new KeyValuePair<string, object?>(
                "outcome", "timeout"));
        log.LogError(
            "Fraud check timed out for order {OrderId}",
            id);
        return Results.StatusCode(502);
    }
}
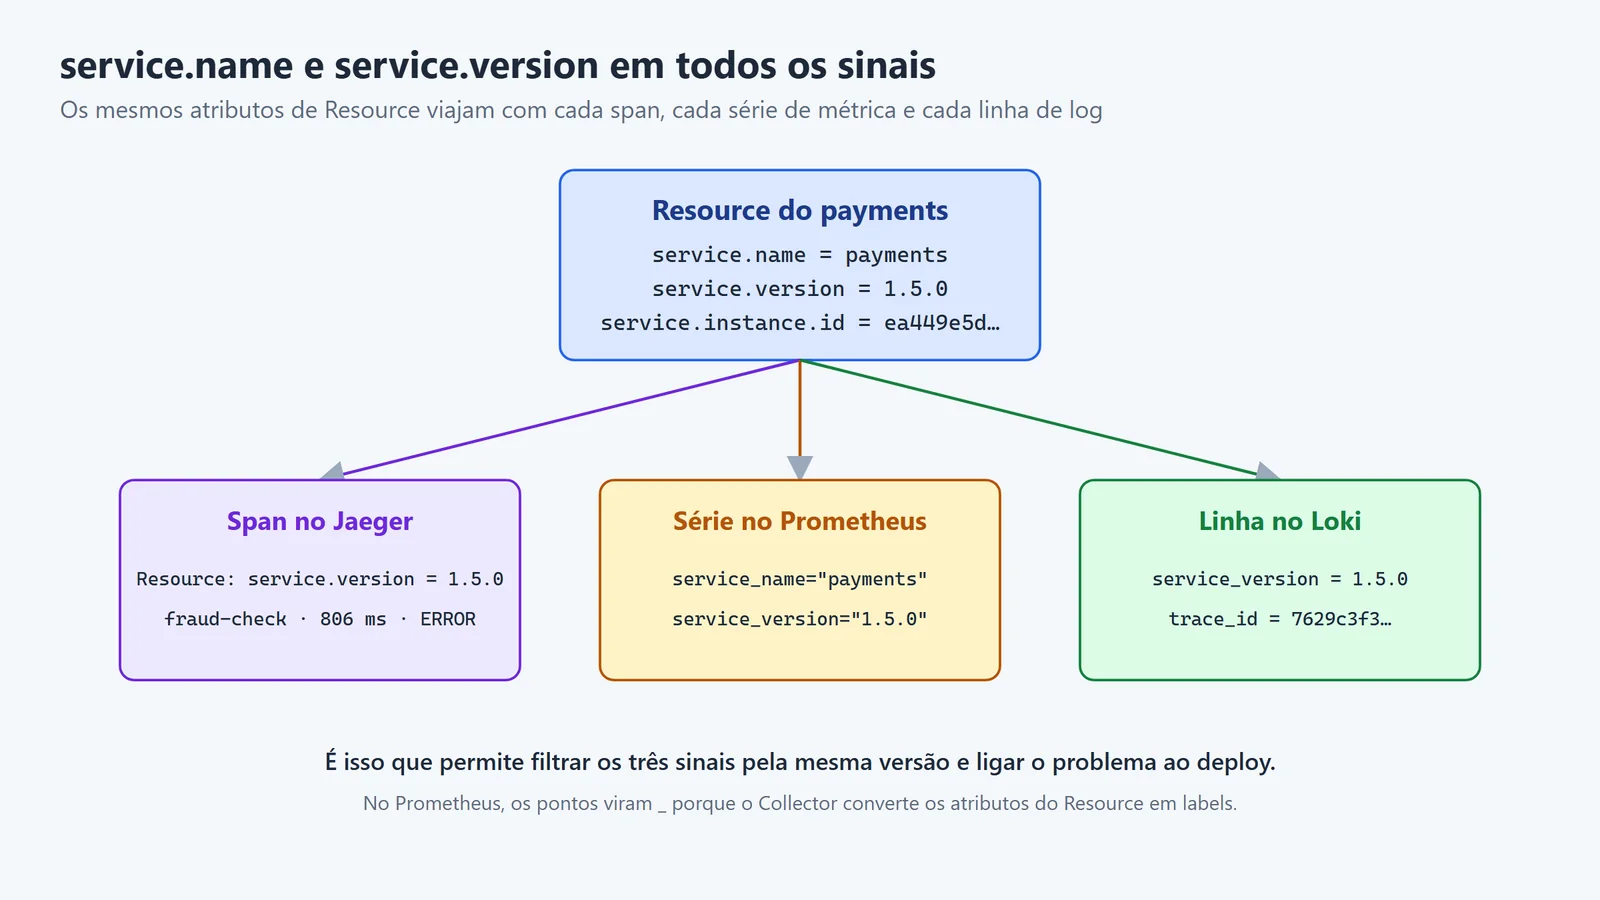
Repare no que não está no código: nenhum trace id no log, nenhum nome de serviço no span, nenhuma versão na métrica. Tudo isso vem do Resource e do contexto do span ativo. O número do pedido vai no span como order.id e no log como OrderId, mas não na métrica, porque cada valor de tag numa métrica cria uma série nova.
O Collector no meio do caminho
Os serviços não conhecem Jaeger, Prometheus nem Loki. Eles mandam tudo por OTLP para o Collector, e o arquivo de configuração dele decide o destino de cada sinal:
exporters:
  # Traces go to Jaeger, which speaks OTLP.
  otlp/jaeger:
    endpoint: jaeger:4317
    tls:
      insecure: true
  # Metrics are exposed for Prometheus to scrape.
  prometheus:
    endpoint: 0.0.0.0:8889
    resource_to_telemetry_conversion:
      enabled: true
  # Logs go to Loki, which also speaks OTLP.
  otlphttp/loki:
    endpoint: http://loki:3100/otlp

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlp/jaeger]
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [prometheus]
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp/loki]
O resource_to_telemetry_conversion faz os atributos do Resource virarem labels no Prometheus: service.version vira service_version, e dá para agrupar qualquer métrica por versão. Sem ele, a versão ficaria numa métrica separada (target_info) e cada consulta precisaria de um join.

O docker-compose.yml do repositório sobe os cinco contêineres, e o Grafana já nasce com as três fontes de dados configuradas. Uma configuração liga os sinais entre si: no Loki, o campo trace_id de cada log vira um link para o trace no Jaeger.
  - name: Loki
    type: loki
    uid: loki
    url: http://loki:3100
    jsonData:
      # From a log line, jump to the trace in Jaeger.
      derivedFields:
        - name: TraceID
          matcherType: label
          matcherRegex: trace_id
          url: "${__value.raw}"
          datasourceUid: jaeger
Rodando o incidente
Com a stack no ar (docker compose up -d), o programa de demonstração sobe os três serviços como processos separados. Ele só muda um detalhe do OpenTelemetry por variável de ambiente:
var info = new ProcessStartInfo(
    Environment.ProcessPath!, [name, version])
{
    RedirectStandardOutput = true,
};
// Export metrics every 5 s instead of every 60 s.
info.Environment["OTEL_METRIC_EXPORT_INTERVAL"] = "5000";
Por padrão, o SDK exporta métricas a cada 60 segundos, o que deixaria o painel com um ponto por minuto. A saída do programa é curta:
payments 1.4.0: 1200 checkouts, 0 errors
payments 1.5.0: 1200 checkouts, 60 errors
O resto da história está nos backends.
O que o Grafana mostra
O painel do repositório tem quatro gráficos: p95 por serviço e versão, erros 5xx por segundo, p95 da verificação antifraude e os logs de erro do payments.

O primeiro gráfico conta a história do deploy sozinho: a linha azul do payments 1.4.0 fica perto de zero e termina; a laranja da 1.5.0 começa perto de 900 ms. A consulta é PromQL comum sobre o histograma nativo do ASP.NET Core, agrupada pelos labels que vieram do Resource:
histogram_quantile(0.95,
  sum by (le, service_name, service_version) (
    rate(http_server_request_duration_seconds_bucket
      {http_route!="/health"}[1m])))
O filtro http_route!="/health" está ali por um motivo: o Filter da instrumentação tirou o /health dos traces, mas não das métricas. As checagens de saúde entram em http.server.request.duration e precisam ser excluídas na consulta.
Para conferir os números sem depender do olho, o repositório tem um check.py que lê os três backends pela API depois da execução:
metrics (Prometheus, whole run, /health excluded)
service   version  requests  5xx   p95
gateway   2.1.0        2400   60    500 ms
orders    3.0.2        2400   60    250 ms
payments  1.4.0        1200    0     49 ms
payments  1.5.0        1200   60    875 ms

logs (Loki): 60 'timed out' lines
  service_version = 1.5.0
  OrderId = 100020
  trace_id = 7629c3f36492827e6704ed8976619a21

trace (Jaeger): 6 spans
  gateway   POST /checkout/{id:int}       825 ms
  gateway   POST                          825 ms
  orders    POST /orders/{id:int}         823 ms
  orders    POST                          809 ms
  payments  POST /payments/{id:int}       807 ms
  payments  fraud-check                   806 ms
As contagens batem exatamente com o que o cliente mandou: 1200 requisições por versão, 60 erros, 60 linhas de log. Os percentis não são exatos, e isso é importante. Um p95 calculado de histograma é uma estimativa dentro do bucket: o payments 1.5.0 aparece com 875 ms porque o valor caiu entre os limites de 750 ms e 1 s. O p95 do gateway, que mistura as duas fases, ficou em 500 ms nesta execução e em 750 ms numa anterior. O problema atinge 5% das requisições do gateway, no limite exato do p95, e o número agregado oscila. Separado por versão, ele não deixa dúvida.
Logs no Loki, com o trace id em cada linha
No Explore do Grafana, a consulta filtra os erros do payments e formata a linha com três campos que o OpenTelemetry mandou sozinho: a versão, o pedido (que veio do template do log) e o trace id.

São exatamente as 60 linhas de erro, todas da versão 1.5.0. O trace id da linha do pedido 100020 leva ao próximo passo.
O trace no Jaeger
A busca no Jaeger por traces do gateway com error=true lista as requisições que falharam, todas com cerca de 825 ms e seis spans com erro, em três serviços:
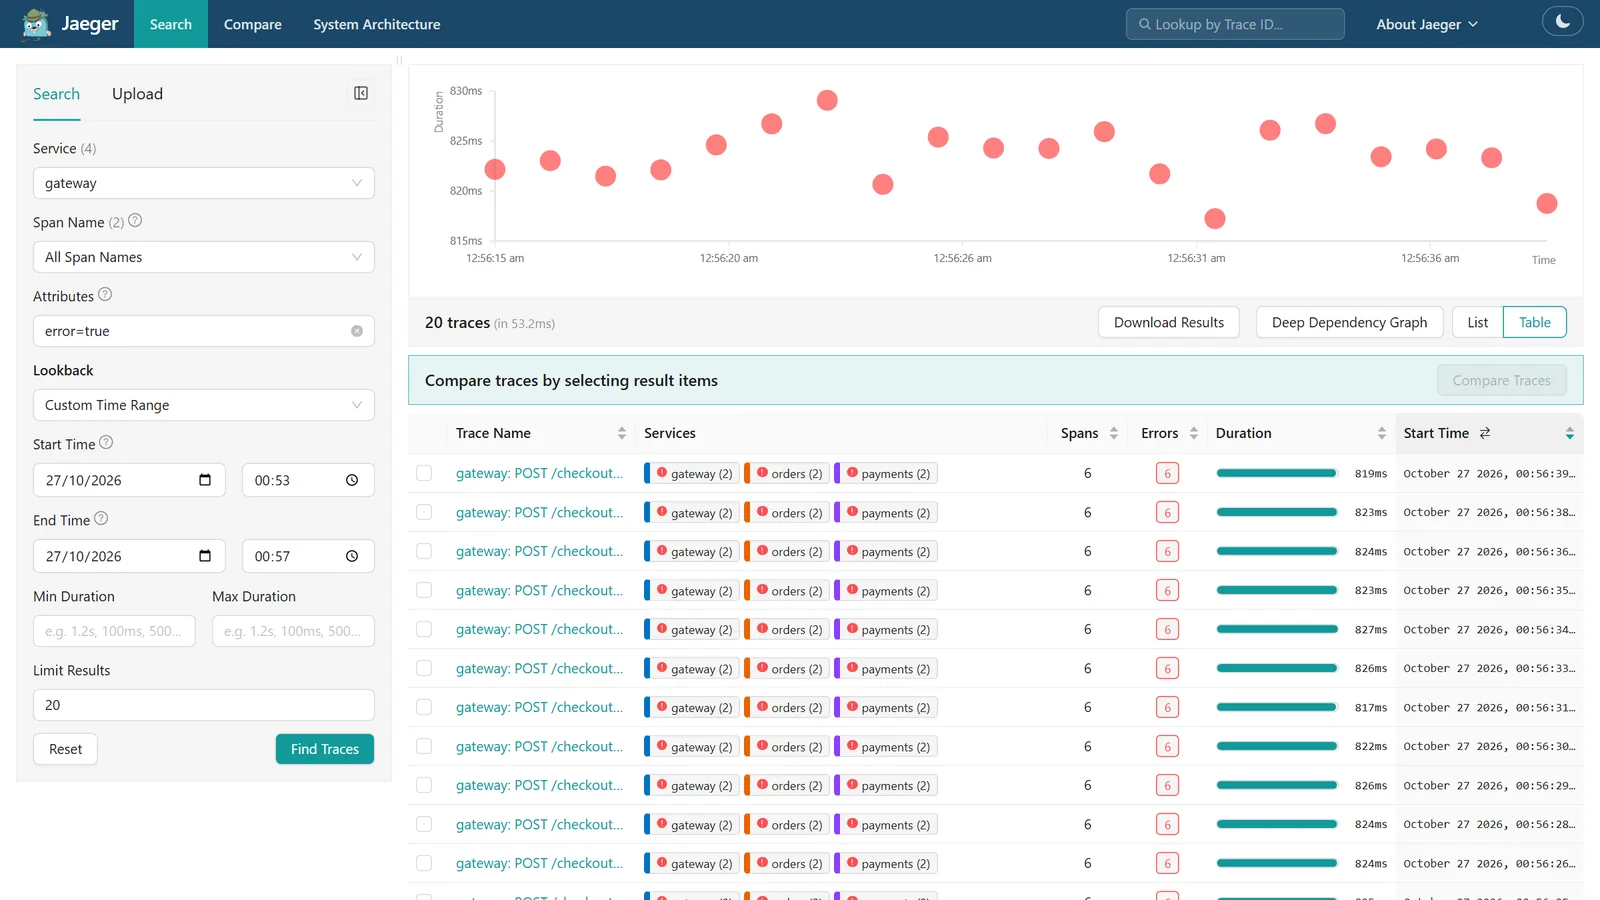
Aberto, o trace do pedido 100020 mostra o caminho inteiro e onde o tempo foi gasto. O span fraud-check traz o atributo order.id, o status timeout e, no Resource, a versão 1.5.0:

Dos 825 ms da requisição, 806 ms foram gastos na verificação antifraude. O gateway e o orders aparecem com erro, mas só repassaram o 502. É a mesma conclusão do artigo anterior, agora com as ferramentas que um time usaria num incidente real.
O erro que o próprio painel pegou
Na primeira execução, o gráfico de p95 da verificação antifraude mostrou 4,75 s para todas as versões, inclusive a 1.4.0, que leva 20 ms. O código estava certo; a medida, não.
O histograma registrava valores em segundos (unit: "s", valores como 0,02), mas os limites padrão dos buckets do SDK são 0, 5, 10, 25, 50, 75, 100, 250 e assim por diante. Esses números fazem sentido para milissegundos. Em segundos, todas as medições caíam no primeiro bucket, de 0 a 5, e o histogram_quantile interpolava 95% desse intervalo: 4,75 s.

A correção é dizer ao SDK quais limites usar, com o InstrumentAdvice do .NET, como no trecho da seção de instrumentação. Com limites em segundos, o p95 da 1.4.0 ficou em 49 ms, o da 1.5.0 em 762 ms para as respostas boas e em 988 ms para os timeouts. Ainda são estimativas, mas agora dentro de buckets que fazem sentido. As métricas do ASP.NET Core não tiveram esse problema porque já vêm com limites em segundos.
Cuidados que valem para produção
- Desligamento limpo. O SDK exporta em lotes. Na primeira execução, o programa matava o processo do payments 1.4.0 logo depois da carga, e o último lote se perdia: o Prometheus contou 1192 requisições em vez de 1200. Um serviço de verdade, parado com SIGTERM, encerra o host e o SDK descarrega o que tem. Matar o processo pula essa etapa.
- Buckets na unidade certa. Todo histograma seu precisa de limites pensados para os valores que ele mede.
- Cardinalidade. Versão, rota, status e resultado são boas tags de métrica. Número de pedido vai no span e no log.
- Intervalo de exportação. 60 segundos é o padrão para métricas. Mais curto dá painéis mais finos e mais tráfego; ajuste por variável de ambiente, sem recompilar.
- Amostragem. Este exemplo guarda 100% dos traces. Com tráfego real, configure amostragem no SDK ou no Collector.
- Collector como ponto de controle. Trocar Jaeger por outro backend, mandar para dois destinos ou filtrar dados sensíveis é mudança no
collector.yaml, não no código. A segurança também mora ali: neste exemplo tudo roda sem TLS e sem autenticação, o que só serve para a máquina local.
Resumo
- O OpenTelemetry não muda a forma de instrumentar em .NET:
ActivitySource,MetereILoggercontinuam sendo as APIs. O SDK coleta e exporta. - Uma chamada por serviço configura o Resource, os três sinais e o exporter OTLP; o trace id entra nos logs sem código.
- O Collector desacopla os serviços dos backends: traces no Jaeger, métricas no Prometheus, logs no Loki, tudo no Grafana.
- O
resource_to_telemetry_conversionpõeservice_versionem toda métrica, e é isso que liga o p95 de 875 ms ao deploy da 1.5.0. - Percentil de histograma é estimativa, e buckets na unidade errada transformaram 20 ms em 4,75 s.
Este artigo continua o Logs, métricas e traces em .NET. Para o que faltou ao payments 1.5.0, um prazo e uma degradação na dependência lenta, leia também Resiliência em .NET. Se você precisa montar observabilidade na sua API, veja o serviço de backend .NET.
Referências
- GitHub: ceseidl/opentelemetry-dotnet (código deste artigo)
- OpenTelemetry: .NET getting started
- OpenTelemetry: Collector configuration
- Microsoft Learn: .NET observability with OpenTelemetry
- Microsoft Learn: Creating metrics in .NET
- Grafana Loki: Ingesting logs with OpenTelemetry
- Jaeger: Documentation